ArcPy 比对地理数据库结构:字段、域与空间参考的迁移前审计
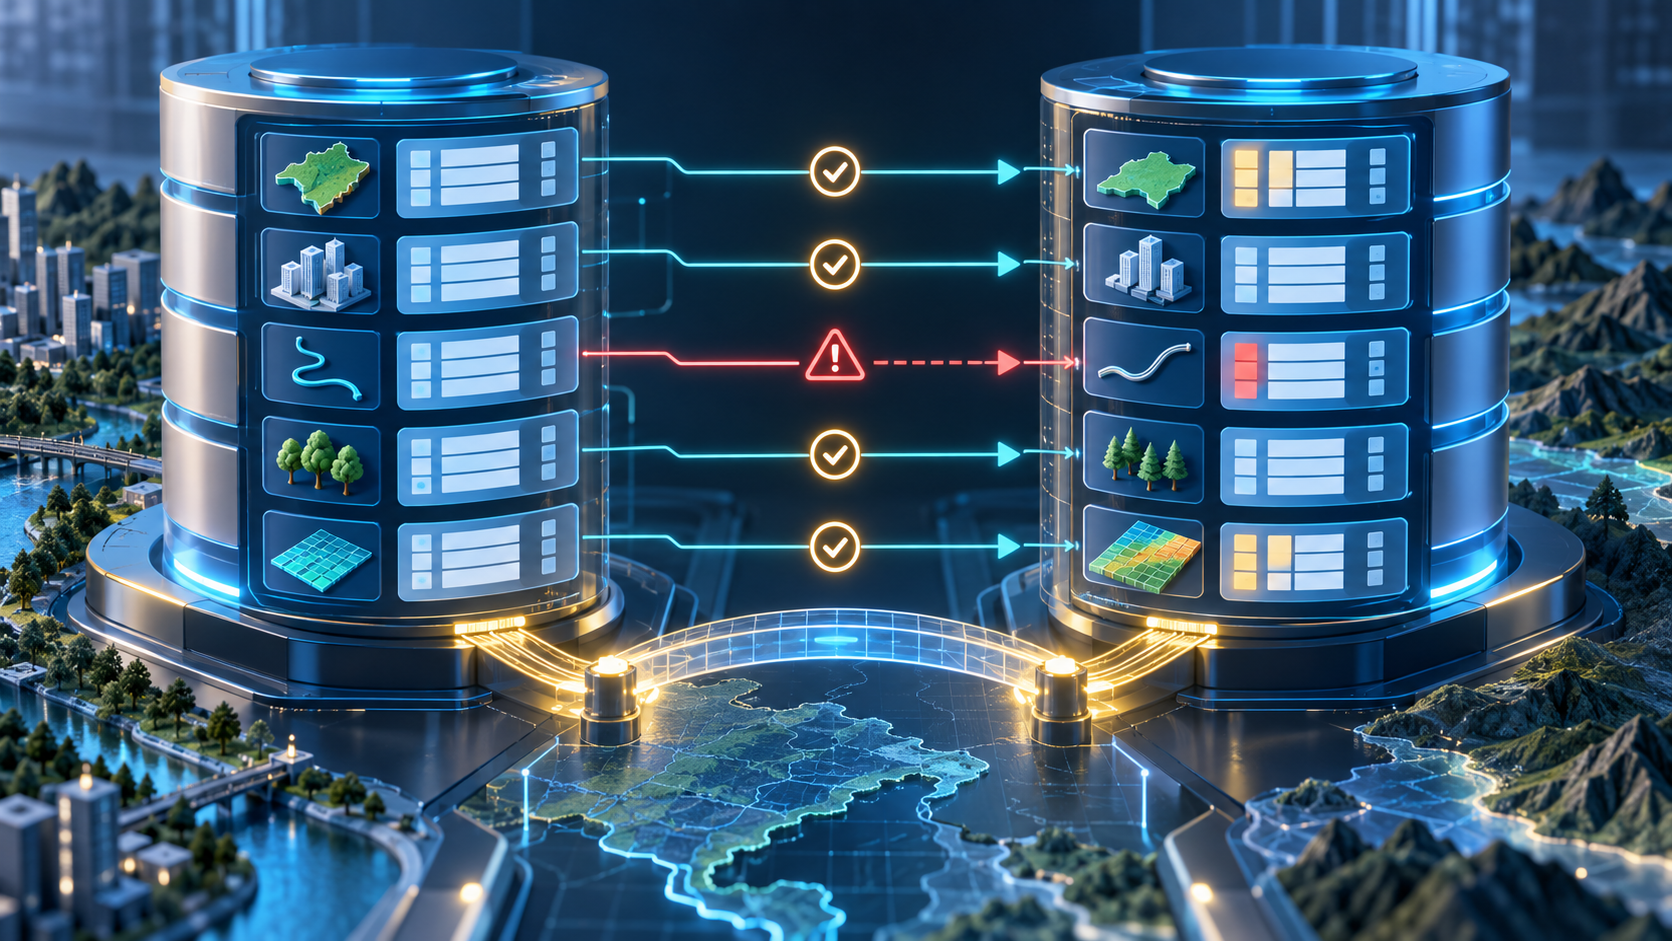
数据迁移前,最容易被低估的不是复制速度,而是“两个库看起来字段相同”的错觉:一个库把道路等级设为域值,另一个只存文本;一个几何精度为毫米,另一个按米;目标表甚至可能缺少编辑追踪字段。ArcPy 可以把结构差异变成清单,让迁移讨论从感觉转到证据。本文给出可落地的迁移前审计路径。
Schema 包含的不只是字段名
字段类型、长度、精度、别名、默认值、可空性、子类型、域和索引共同决定数据能否正确写入。只比字段名会漏掉最常造成静默截断的差异。
空间参考要比参数而非名字
两个 CRS 名称相似不表示相同。应比对 WKID、单位、XY 容差、XY 分辨率及垂直参考;这会直接影响长度、捕捉和拓扑。
域值差异是业务变更信号
源库出现目标库没有的状态码,可能是新业务,也可能是录入错误。迁移脚本不能擅自把它归为“其他”,应输出集合差供数据管理员确认。
审计输出应机器可读
人工看控制台无法复用。将差异写成 CSV 或 JSON,后续可作为迁移准入闸门,也便于审批后留档。
可执行实操流程
- 列出源库与目标库所有 Feature Class、Table 和 Relationship Class,先比对象清单,避免只审计已知图层。
- 用 arcpy.ListFields 和 Describe 提取字段、空间参考、OID、GlobalID、编辑追踪与几何类型,写入结构快照。
- 读取域定义和子类型,比较编码集合、描述和默认值;对新增、缺失和含义改变的项分别标记。
- 为每个对象生成差异报告,按阻断迁移、需映射、仅文档差异分类;没有通过的对象不进入 Append。
- 在沙箱迁移一份代表性数据,复核记录数、空值率、域命中和 geometry extent,再批准正式批次。
desc = arcpy.Describe(fc)
fields = [(f.name, f.type, f.length, f.isNullable) for f in arcpy.ListFields(fc)]
sr = (desc.spatialReference.factoryCode, desc.spatialReference.linearUnitName)
# 将 fields 与 sr 序列化为 JSON 后做差异比对
项目避坑与质量检查
只比较 WKID 仍可能漏掉 XY 容差差异,特别是从 CAD 或历史库导入的要素。容差放大后,后续拓扑检查可能“莫名”吸附。我的做法是把空间参考完整属性作为审计项,并让迁移报告明确哪些差异会影响几何编辑,而非把它们藏在备注里。
| 检查阶段 | 必须保留的证据 | 异常处理 |
|---|---|---|
| 输入 | 对象清单、完整字段属性与空间参考 | 隔离异常样本,不直接覆盖源数据 |
| 处理 | 域/子类型集合差和迁移准入状态 | 回到参数、单位与筛选条件逐项复现 |
| 交付 | 沙箱迁移前后记录数、空值率及范围 | 用独立样本或第二个环境复核 |
让流程能被下一位同事复跑
迁移批准后也不要删除结构快照。它既是验收基线,也是下一次升级时定位变化的依据;对被批准的字段映射要记录责任人和业务解释。
把源数据批次、坐标参考、关键参数、异常清单和前后统计放在同一份处理记录中。这样数据更新时,团队判断的是结果差异来自哪里,而不是重新猜测上一次做过什么。
抽样复核与交接记录
建议为每次审计生成带时间戳的基线文件,并将“允许差异”从脚本常量移到受版本控制的配置。这样目标库新增一个合法字段时,审计不会被迫停摆;而空间参考、主键或域值等高风险变化仍会明确阻断。正式迁移前由数据负责人签认差异清单,比事后追查异常批次成本低得多。
FAQ
字段别名不同会阻断迁移吗?
通常不会阻断写入,但会影响用户理解与表单显示,应作为文档或统一项处理。
域新增编码能自动写入吗?
技术上可写,但业务上不应默认接受。先确认目标模型是否需要扩展该编码。
只看 WKID 是否够?
不够。还应检查单位、XY 容差和分辨率,必要时检查垂直参考。
总结
迁移前结构审计不是额外流程,而是防止错误写入生产库的最短路径。先把差异量化,批量入库才有依据。