
用GeoPandas读取Shapefile文件

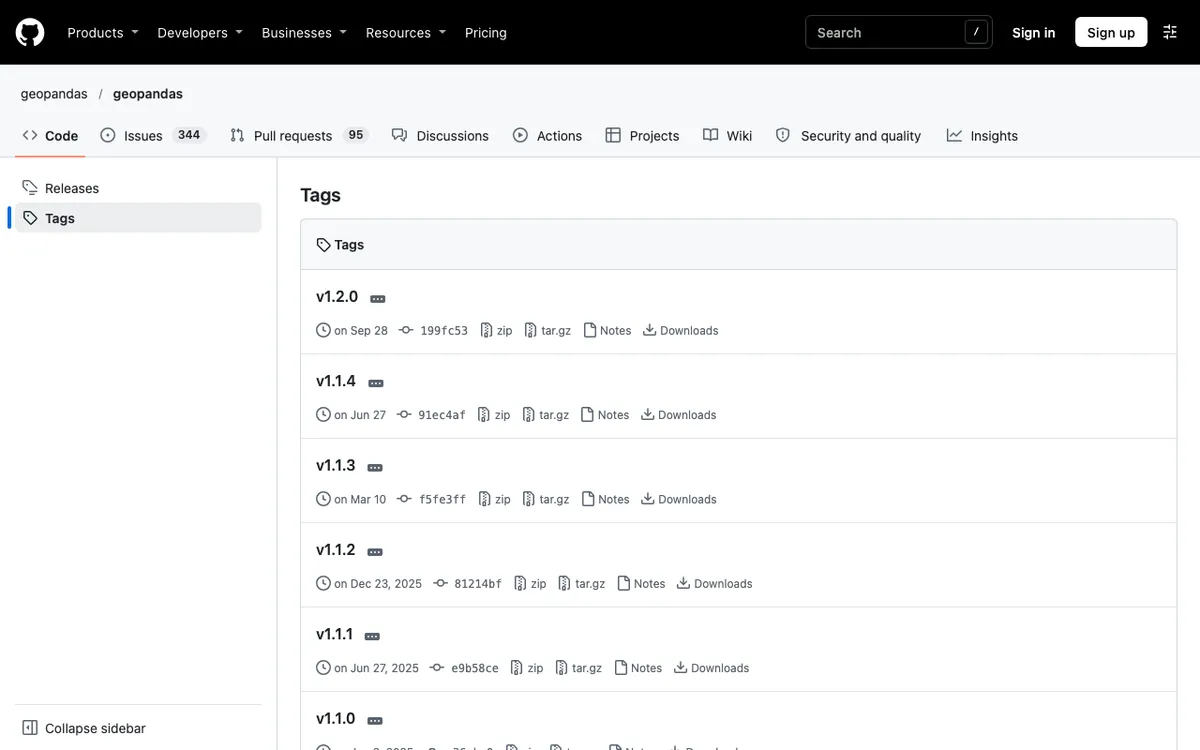
用 GeoPandas 读取 Shapefile 文件,直接调用 geopandas.read_file() 并传入 .shp 路径,即可得到包含几何列与属性表的 GeoDataFrame。它底层通过 pyogrio(默认)或 Fiona 调用 GDAL/OGR,会自动加载同目录下的 .shx、.dbf、.prj、.cpg 等配套文件。截至 2026 年 11 月,稳定版为 GeoPandas 1.2.0(2026 年 9 月 28 日发布),要求 Python >= 3.11,读取时还可指定 encoding、bbox、use_arrow 等参数。文件完整且编码正确时,几行代码就能完成加载并用于后续空间分析。
基本读取步骤
面向已安装 GeoPandas 的 GIS 学习者,核心目标是把本地或远程 Shapefile 稳定加载为可操作的 GeoDataFrame。按下面顺序执行即可验收:
- 导入库:import geopandas as gpd
- 准备路径:使用绝对路径或相对路径指向 .shp 文件;也可直接给 ZIP 或 URL
- 调用读取:gdf = gpd.read_file(“path/to/your.shp”)
- 立即验收:查看 gdf.head()、len(gdf)、gdf.crs、gdf.geometry.name,确认行数、坐标系和几何列存在
- 需要过滤时再加参数(见后文),避免一次载入过大文件
最小可运行示例:
import geopandas as gpd
gdf = gpd.read_file(“/data/boundaries.shp”)
print(gdf.head())
print(gdf.crs)
读取成功后,若要立刻做地图可视化,可参考GeoPandas读取Shapefile后的GIS地图可视化教程,把 GeoDataFrame 画成图层。
Shapefile 配套文件说明
Shapefile 是多文件格式,缺少关键文件会导致读取失败或信息丢失。GeoPandas 只需你传入 .shp,其余同名文件会自动关联:
- .shp:几何(点、线、面),必须存在
- .shx:空间索引,必须存在
- .dbf:属性表,必须存在
- .prj:坐标系定义(WKT),强烈建议有;缺失则 gdf.crs 为 None
- .cpg:字符编码声明,中文或特殊字符场景建议保留
把整套文件放在同一目录,不要只拷贝 .shp。若从网上下载 ZIP,可直接用 zip 协议读取,无需先解压:gpd.read_file(“zip:///path/to/archive.zip”) 或带内部路径 “zip:///path/to/archive.zip!folder/file.shp”。从 URL 读取时同理,确保服务器能返回完整配套文件。
read_file 常用参数怎么选
额外参数会原样传给底层 pyogrio.read_dataframe() 或 fiona.open()。按需选择即可,不必一次全写。下表列出日常最高频的参数(以官方文档为准):
| 参数 | 作用 | 典型用法 |
|---|---|---|
| path | 文件、目录、ZIP、URL 或文件对象 | “data.shp” 或 “zip://data.zip” |
| encoding | 强制指定属性表字符编码 | encoding=”utf-8″ 或 “gbk” |
| bbox | 按矩形范围过滤(minx, miny, maxx, maxy) | bbox=(120, 30, 122, 32) |
| mask | 用另一个几何对象做空间过滤 | mask=another_gdf |
| rows | 只读前 N 行或切片,便于探查 | rows=100 或 rows=slice(0, 50) |
| columns | 只加载指定属性列,减小内存 | columns=[“NAME”, “CODE”] |
| engine | 选择后端:”pyogrio”(默认更快)或 “fiona” | engine=”pyogrio” |
| use_arrow | 启用 Arrow 加速(需安装 pyarrow),通常提速 2~4 倍 | use_arrow=True |
| layer | 多图层文件时指定图层名或索引 | layer=”admin” |
大文件优先组合 bbox / mask / columns / rows;追求速度时保持默认 pyogrio 并加 use_arrow=True(也可设环境变量 PYOGRIO_USE_ARROW=1)。注意:当前 pyogrio 引擎不支持在 read_file 时直接传 crs 参数,坐标系一律从 .prj 自动读取。
编码、CRS 与常见报错处理
读取失败时先定位三类问题:路径与配套文件、字符编码、坐标系。
- 编码错误(乱码、CPLE_AppDefinedError、recode 失败):显式写 encoding=”utf-8″(或实际编码如 “Windows-1252″、”iso-8859-15″)。确认有 .cpg 文件;顽固情况可用 ogr2ogr 把源文件转为 UTF-8 后再读。
- CRS 为空或错误:没有 .prj 或内容为空时 gdf.crs 为 None。读取后再设置:gdf = gdf.set_crs(“EPSG:4326”, allow_override=True)。不要指望在 read_file 里用 crs= 参数(pyogrio 会警告)。
- DriverError / 文件不存在:检查路径拼写、相对路径是否基于当前工作目录、同目录是否齐套 .shp/.shx/.dbf。文件损坏时用 QGIS 打开验证。ZIP 路径格式写错也会触发此错误。
- 缺少几何列或环境异常:多半是依赖冲突。新建干净 conda-forge 环境重装,核对 numpy、pandas、shapely、pyogrio、pyproj 版本匹配。依赖清单可对照官方 pyproject.toml。
验收标准:读取后 gdf 非空、geometry 列 dtype 为 geometry、crs 符合预期、无大量无效几何(可用 gdf.is_valid 抽查)。当前版本信息也可在GeoPandas GitHub 标签页随时核对。
常见问题
为什么只给 .shp 路径就能读到属性和投影?
Shapefile 约定同名配套文件放在同一目录,GeoPandas/GDAL 会按扩展名自动查找并合并,因此无需手动指定 .dbf 或 .prj。
大文件内存爆了怎么处理?
用 bbox、mask、rows、columns 或 where 条件在读取阶段过滤;同时开启 use_arrow=True。先用 rows=100 探查字段,再决定全量加载策略。
从 GitHub 或网盘直接读 Shapefile 失败怎么办?
普通 raw 链接往往只返回单个文件。改用完整 ZIP 下载地址,或本地下载齐套后再读;也可尝试 GDAL 的 /vsicurl/ 前缀(需环境支持)。
读完后字段名被截断或出现奇怪字符?
这是 Shapefile 本身限制(字段名最长约 10 字符、部分字符不支持)。读取阶段无法彻底消除,建议源头用 GeoPackage 或在读取后立刻 rename 列名,并检查 encoding。
总结:用 GeoPandas 读取 Shapefile 的核心就是 gpd.read_file() + 完整配套文件 + 正确 encoding/CRS。建议每次读取后立刻用 head()、crs、is_valid 做三步验收,大文件务必加过滤参数并启用 Arrow;读完若需出图,直接参考本站 GeoPandas 与 Shapefile 可视化说明继续操作。