QGIS 字段映射怎么用:合并图层时字段对齐、重命名与覆盖规则
问题场景:字段名一样,不代表字段真的能合并
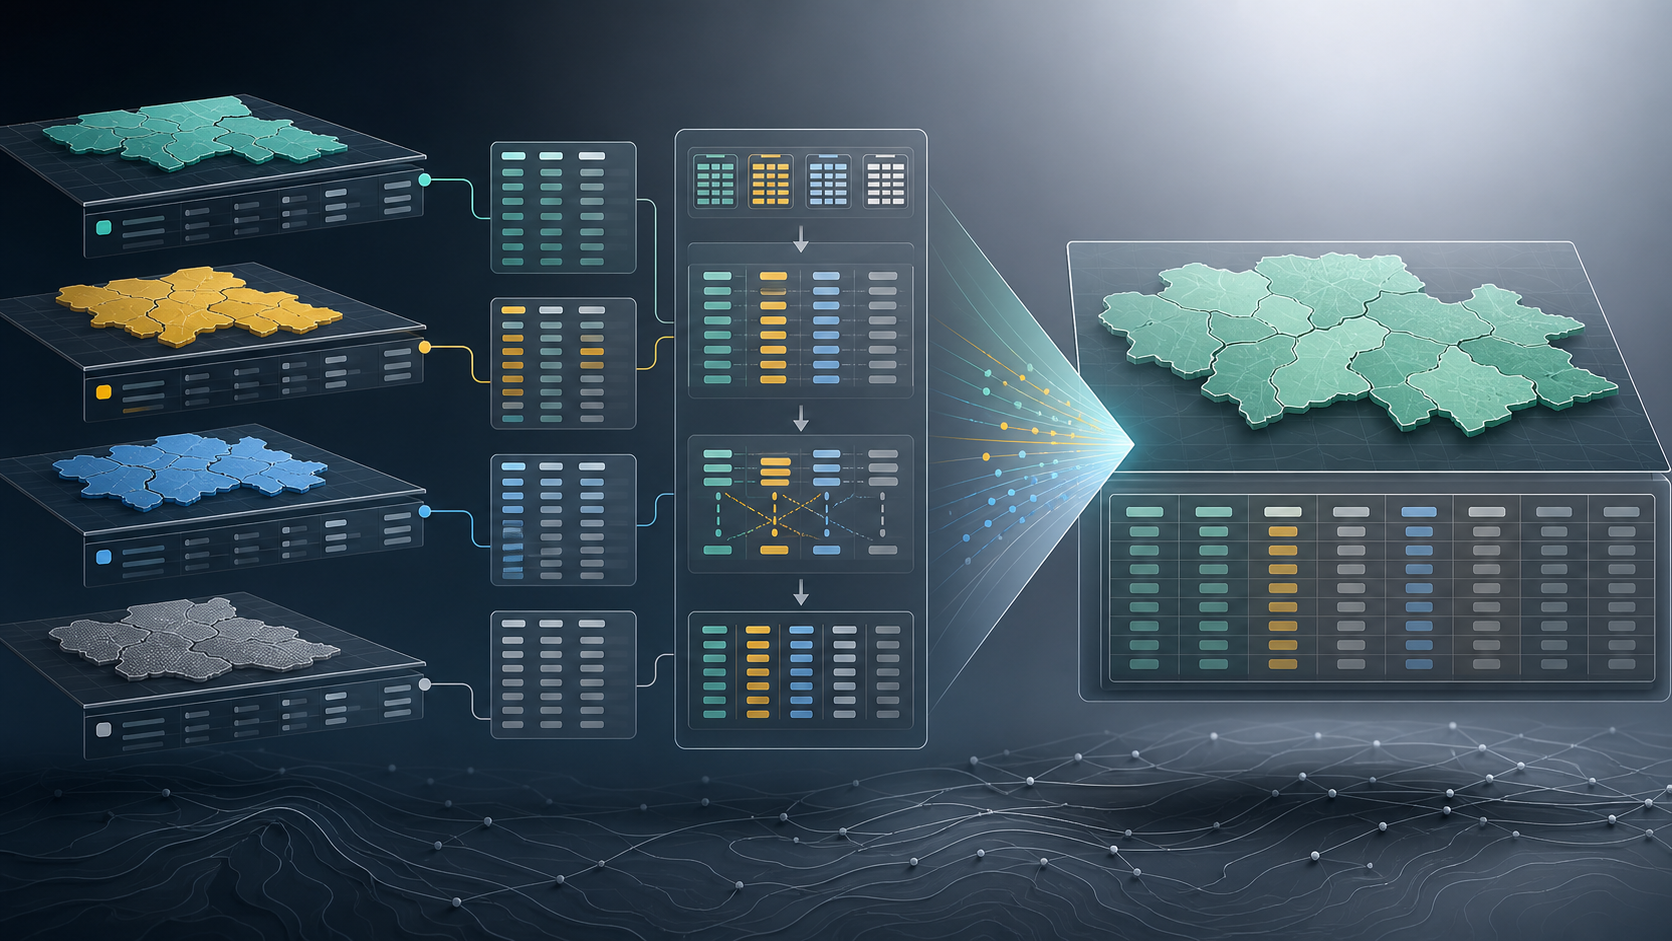
做 QGIS 字段映射 时,最容易让人掉以轻心的,就是那种“看起来已经差不多”的数据。图层 A 里有 `name`、`type`、`code`,图层 B 里也有差不多的列,于是很多人就直接合并。结果要么文本被截断,要么类型被强制改写,要么统计表一做就发现分类全乱了。
我在项目里见过一种很典型的返工:前期为了赶制图,先把多个来源数据硬合成一份成果层;等到了字段统计、自动制图、服务发布阶段,才发现字段语义根本不统一。那时再回头修,不只是改一列字段,而是整条处理链都要重跑。
所以字段映射真正解决的不是“工具面板怎么点”,而是多源数据之间怎么建立一套 可复用、可交付、可继续分析 的字段契约。这个观念一旦立住,后面的合并、汇总和入库才会顺。
先把问题分开:字段名、字段类型、字段语义
很多教程只强调字段名对应关系,但实际工程里,至少要同时检查三层:名字是否对应、类型是否兼容、语义是否一致。这三层里只要有一层没对齐,合并后的结果就不可靠。
| 检查层 | 常见误判 | 后果 |
|---|---|---|
| 字段名 | 看到别名相似就当同一字段 | 映射到错误列 |
| 字段类型 | 整数和文本直接并入同一列 | 空值、报错或隐式转换 |
| 字段语义 | 相同编码却代表不同业务含义 | 后续统计和分级失真 |
| 字段长度 | 默认长度太短 | 中文或长编号被截断 |
尤其是在历史数据、外包数据和手工整理数据混在一起时,字段名往往只是最浅的一层。真正难的是语义统一。比如 `type=1` 在一份数据里代表主干道,在另一份数据里代表一级地类,这种坑表面上完全看不出来。
项目里最容易忽略的是字段语义对齐
我更建议先整理一份目标字段设计表,再回头做映射,而不是打开工具后边看边想。字段设计表不需要很复杂,但至少要写清 目标字段名、类型、长度、含义、允许空值规则、来源列。
这样做的好处很直接:当你需要第二次合并、换一批数据源、或者把成果交给同事继续处理时,大家讨论的是同一套结构,而不是凭印象猜字段。对经常要进 GeoPackage、PostGIS 或脚本流程的数据,这一步尤其值钱。
一套能落地的字段映射流程
- 先抽样看 20 到 50 条记录,确认每个关键字段的真实取值长什么样,不只看字段名。
- 整理目标字段表,明确哪些字段保留原值,哪些需要重命名,哪些需要新建过渡字段。
- 对类型不兼容的列先做预处理,例如把数值编码转成统一文本,或者补全长度更长的新字段。
- 在 QGIS 合并或重构字段时完成映射,不要把含义不明的列先硬塞进去。
- 输出后立即做二次抽查:看空值、长度、分类统计、字段覆盖是否符合预期。
如果你预期后续还会继续更新这批数据,最好把映射逻辑写成处理说明,甚至固化成脚本。字段映射最怕的是这次靠记忆做对了,下次却没人记得为什么要这么做。
一个真实返工点:把别名当字段名
这件事在中文数据里特别常见。界面上显示的是“道路等级”“所属街道”“数据来源”,很多人以为底层字段名也就是这个,结果真正跑工具时才发现底层是 `road_cls`、`street_nm`、`src_tag`。如果两个图层别名相似但底层字段不同,映射时非常容易错位。
我自己的做法是,凡是要进入批处理或共享交付的图层,都先看底层字段结构,不用别名做关键判断。别名可以服务阅读,但不能替代结构设计。
结果复核时不要只看一张图
很多人会在输出后简单浏览一下属性表,觉得列都在、数据也有,就当成功。这个检查太浅了。字段映射做完后,至少还要看 分类统计、空值比例 和 长度截断。真正有问题的往往在这里露出来。
- 用唯一值或分类统计快速看是否出现异常类别。
- 按关键字段筛选空值,确认是不是映射失败而不是原始数据本来就空。
- 抽查几条长名称和长编码,确认没有被截断。
FAQ
字段名完全一样,还需要做字段映射吗?
需要。字段名相同不代表字段类型、长度和业务含义一致,尤其是多来源数据合并时,直接依赖字段名风险很高。
QGIS 合并后有些字段整列为空,最先查什么?
先查目标字段类型是否兼容,再查是否映射到了错误来源列,最后检查原始数据是否存在空字符串、NULL 或异常编码。
字段映射逻辑值得专门留档吗?
值得。只要数据会重复更新、需要团队协作,字段映射规则就是成果结构的一部分,不应该只存在于某个人的记忆里。
总结
QGIS 字段映射真正考验的是数据治理意识,而不是工具熟练度。把字段当成成果契约来设计,后面的统计、制图、发布和入库才会稳定。
当你先统一字段结构,再做合并和抽查,这类工作就不再是一次性手工劳动,而会变成可以重复复用的标准流程。