多环缓冲区怎么做:服务范围分析、权重分区与结果解释
问题场景:多环缓冲区做得快,解释却最容易发虚
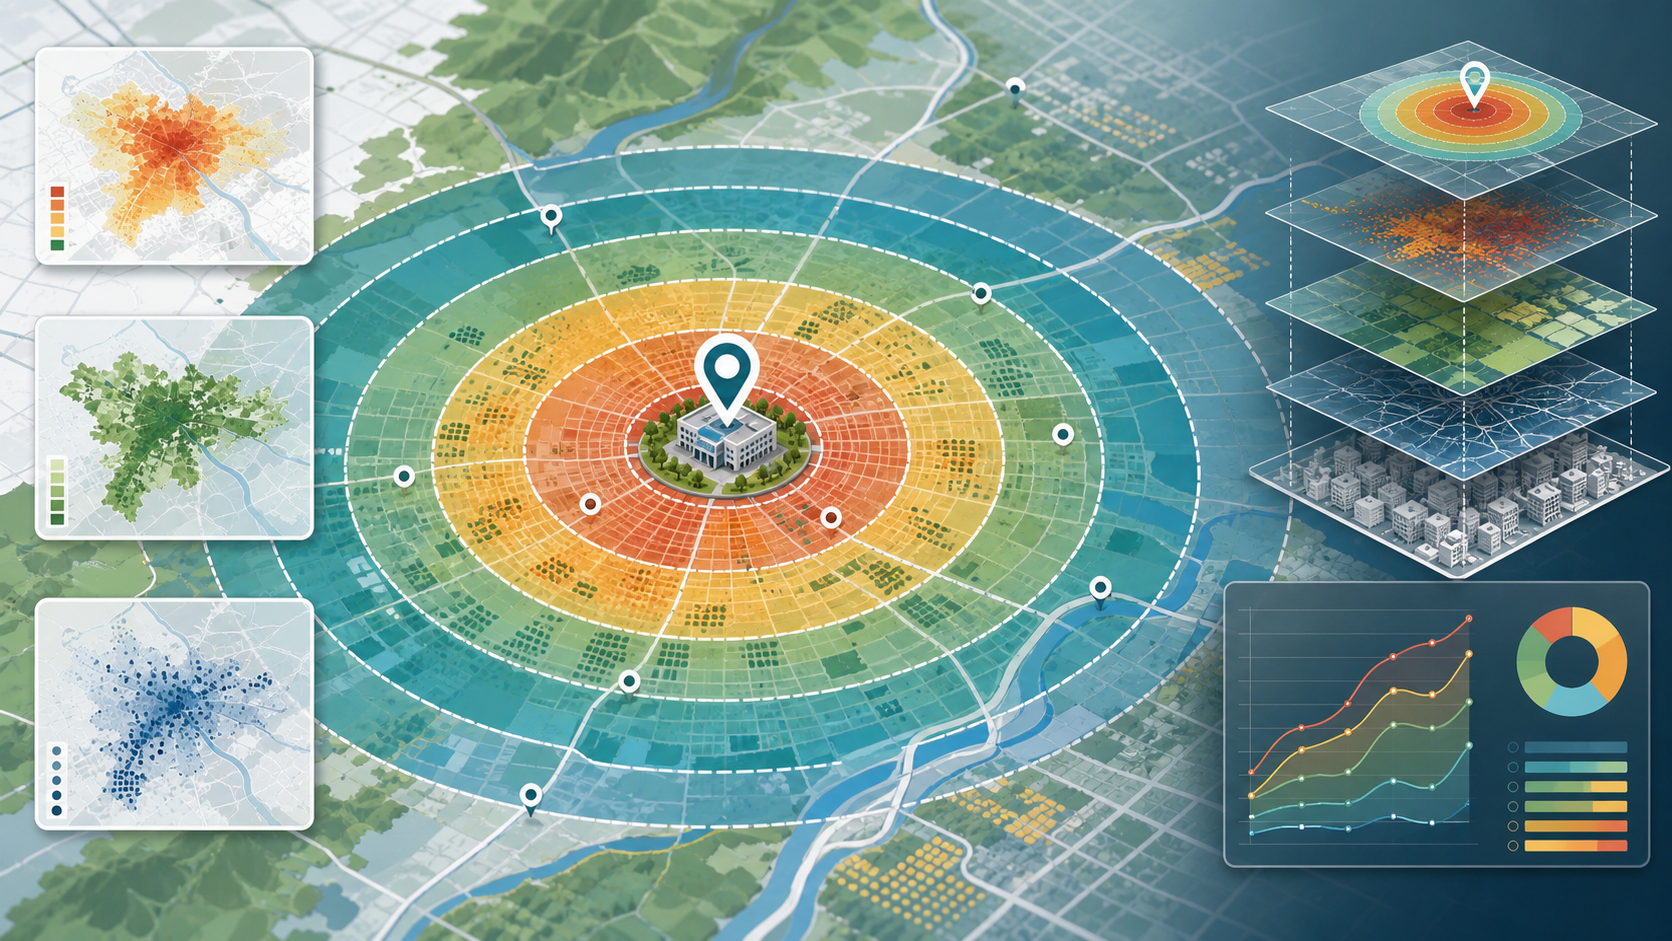
做 多环缓冲区 很容易给人一种“分析已经完成”的错觉。500 米、1000 米、1500 米,一圈圈画出来,图面也很直观。但到了项目讨论阶段,最常见的问题其实是:这些圈到底代表什么?是直线距离、步行可达、服务影响范围,还是只是一种近似表达?
多环缓冲区之所以好用,是因为它能快速把距离分层可视化;多环缓冲区之所以容易被质疑,也是因为很多人只画了圈,却没有把距离含义和权重解释清楚。
先确认距离定义是不是站得住
| 场景 | 直接用欧式缓冲合适吗 | 更稳的补充思路 |
|---|---|---|
| 初筛选址 | 通常可以 | 作为第一轮过滤 |
| 步行服务圈 | 不完全够 | 结合路网服务区更合理 |
| 复杂山地或水网区域 | 风险较高 | 加入障碍或地形约束 |
| 风险扩散近似表达 | 可用 | 要明确它只是近似模型 |
真正做项目时,最要避免的是把“近似距离表达”误讲成“真实服务能力范围”。前者是工具,后者是结论,中间不能省掉说明。
多环缓冲区的核心不是画圈,而是分层解释
尤其在适宜性评价、设施覆盖和服务公平性分析里,不同环带通常对应不同权重。比如 500 米内赋 3 分,500 到 1000 米赋 2 分,1000 到 1500 米赋 1 分。这个权重本身就带有业务判断,不能只写在脑子里。
如果权重来自规范、问卷、历史经验或者项目共识,都应该留痕。因为一旦后面有人追问为什么是这个梯度,你需要给出一个能复现的回答。
一套更像项目分析的流程
- 先定义距离含义:是直线距离、时间距离还是影响半径。
- 确定环带分级和权重规则,并记录依据。
- 生成多环缓冲后检查重叠区域,先决定是取最近、最高等级还是累计影响。
- 与人口、用地、设施等目标数据叠加统计,输出每一环带结果。
- 在结论里明确说明这是近似分析还是可直接用于正式决策的结果。
如果只是为了快速筛查,多环缓冲已经非常好用;如果要直接支撑精细决策,就得更谨慎地说明它的边界。
最常见的返工点:多个设施重叠后没人知道怎么算
多个学校、医院、站点一起做多环缓冲时,重叠区域几乎一定会出现。可如果前面没先定义规则,后面一会儿按最近设施算,一会儿按最高等级算,结果就会来回漂。
这类问题不是技术难,而是规则必须先定。我的经验是,缓冲前先把重叠处理策略写下来,再跑一组小样本验证,比事后解释省事得多。
结果复核要覆盖解释层
- 核对每个环带的面积和对象数量是否在常识范围内。
- 重点看重叠区处理是否一致,而不是只看整体图面。
- 检查结论描述有没有把近似距离误说成真实服务能力。
FAQ
多环缓冲区能直接代表服务区吗?
通常只能近似表达。若服务能力明显受路网、地形或障碍影响,应进一步做网络分析。
缓冲距离怎么设更靠谱?
优先参考业务规范和本地经验,再用真实样本验证,而不是为了图好看随意取整。
重叠环带应该怎么统计?
先定义策略,例如取最近设施、最高等级或累计影响,再统一执行,不能边算边改规则。
总结
多环缓冲区是很好用的 GIS 快速分析工具,但真正有价值的不是圈本身,而是距离含义和权重逻辑是否说得清。
当你把‘画圈’升级成‘有规则的分层解释’,这份结果才更接近项目里可以拿来讨论和复用的成果。