ArcGIS Pro 重分类怎么做:Reclassify 工具、阈值设计与结果核查
问题场景:重分类最怕“阈值看着合理”
很多人做 ArcGIS Pro 重分类,会把注意力集中在 Reclassify 面板里的区间设置。这个动作当然重要,但项目里真正容易出错的,是阈值背后的依据根本没有说清楚。你是在按行业标准分级,按样本分布分级,还是只是为了让图面更好看?这三种分法看起来都像重分类,意义却完全不同。
我见过最典型的返工,是前期为了出一张汇报图,临时把坡度栅格分成五档。后来这张分级结果又被拿去做适宜性评价、加权叠加和专题图发布,等到有人追问每一档为什么这样切时,项目组已经说不清依据了。
所以重分类的关键并不只是“把连续值切开”,而是把 分级依据、输入质量和结果用途 同时讲明白。
先确定阈值属于哪一类
| 阈值来源 | 适合场景 | 最大风险 |
|---|---|---|
| 行业或业务标准 | 需要统一口径、跨项目比较 | 本地样本可能不贴合 |
| 样本统计分布 | 只解释当前区域特征 | 跨期比较不稳定 |
| 经验分层 | 前期探索、快速汇报 | 主观性高,复现困难 |
| 展示分级 | 地图表达 | 容易被误当成分析分级 |
很多人把这四类阈值混在一起用,所以后面才会越做越乱。经验上,只要结果后续还会参与分析,就尽量别让“展示阈值”反向进入分析流程。
重分类前先检查输入值域和 NoData
真正做项目时,我通常先看三件事:值域是否正常、异常值是否存在、NoData 有没有混进有效范围。这一层不查,阈值设计再漂亮也可能立在错误数据上。
例如 DEM、热度指数、遥感反演指标这类连续栅格,经常会带着极端噪声值或者裁剪边缘的残留像元。你如果直接按这些值去分级,最后得到的分区图很可能逻辑完整、颜色也好看,但解释完全站不住。
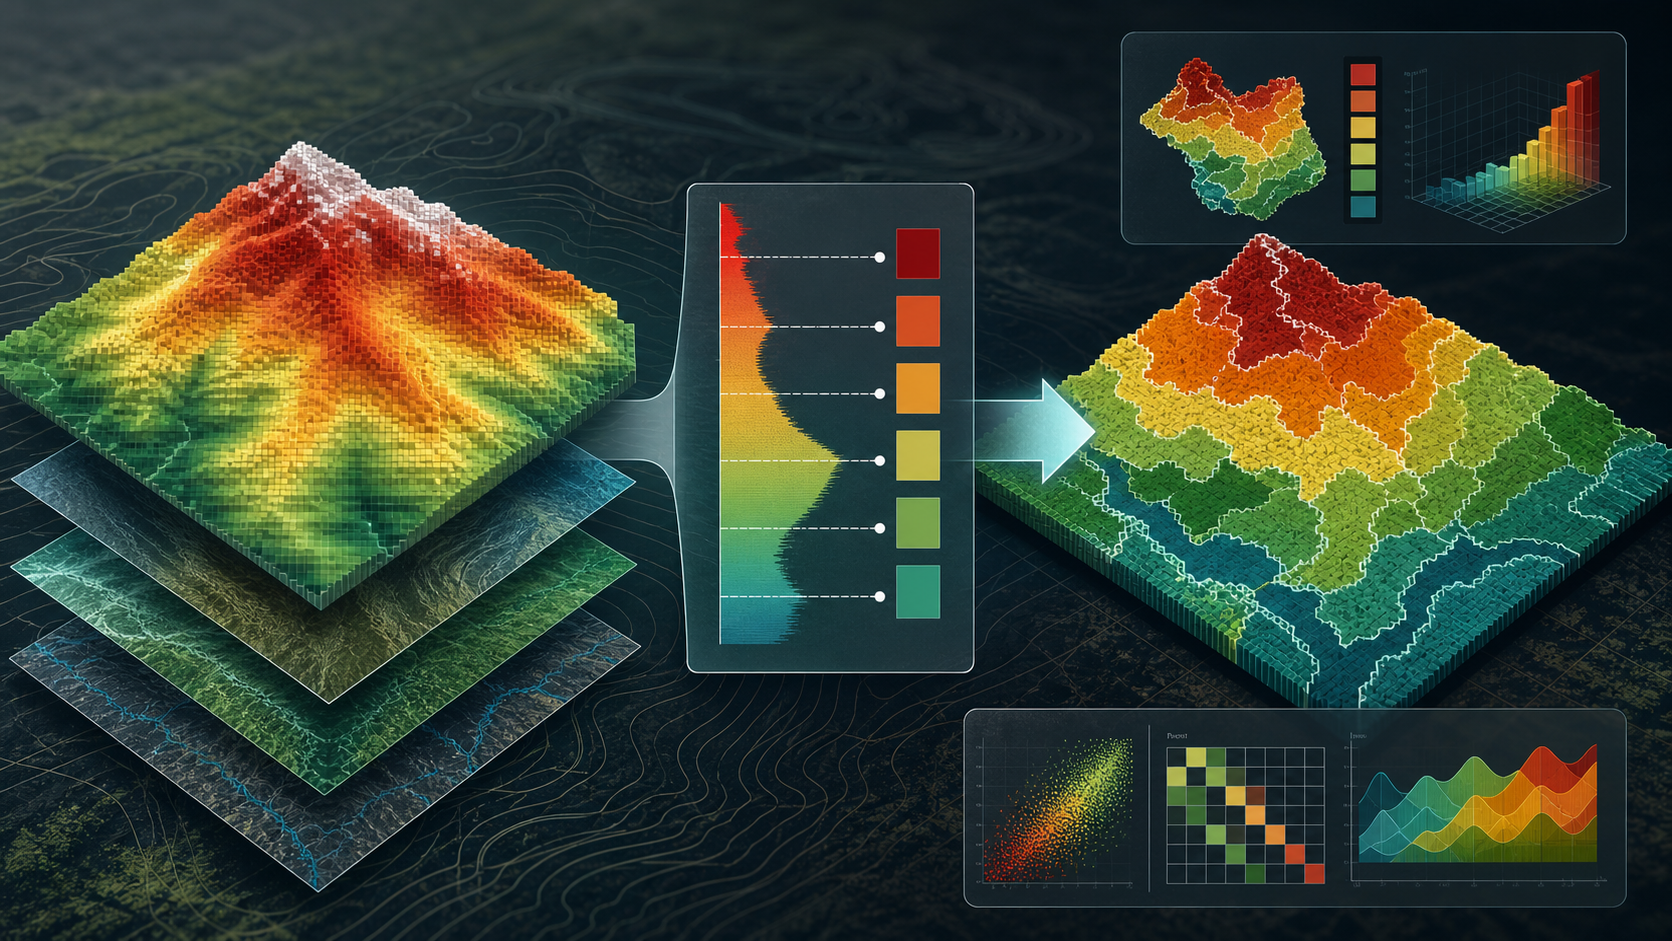
一个稳妥的重分类流程
- 先查看栅格最小值、最大值、直方图和异常值分布,确认输入值域可信。
- 明确阈值依据,并把依据写成一句能说清楚的话,而不是只留在脑子里。
- 在 Reclassify 中设置输入范围与输出编码,同时记录每档的含义。
- 输出后叠加已有认知较强的地物区域,看分级结果是否与地表实际相符。
- 将分析重分类与制图分级分开保存,避免后续混用。
如果项目要求复算,我建议同时保留 原始连续栅格、重分类规则表 和 输出编码栅格。这三样都在,后面无论重跑还是解释,都更稳。
项目现场里最常见的误判
最常见的误判其实不是参数写错,而是把“统计上看起来均匀”当成“业务上就合理”。比如一份生态指标数据自然断点切出来很漂亮,但如果用于红线管理或等级管控,阈值常常必须回到制度标准,而不是只看数据分布。
换句话说,重分类首先是业务判断,其次才是栅格处理。脱离业务语境谈阈值,最后很容易做出一张图面高级、解释却空心的成果。
结果复核时要看三层
- 看数量:各等级面积占比是否异常,是否被少数极值拉歪。
- 看空间:高值区、低值区是否落在认知上合理的位置。
- 看用途:这份结果是给模型继续算,还是只是给人看,两者不能混。
FAQ
重分类结果全落在一两个等级里,是工具有问题吗?
通常不是。更常见的原因是阈值与输入值域不匹配,或者 NoData、异常值干扰了分级。
自然断点和固定阈值怎么选?
如果目标是解释当前样本分布,自然断点很常用;如果要跨期、跨区、跨项目比较,固定阈值通常更稳。
输出编码该直接写评分还是只写等级号?
分析流程里更推荐简洁编码,并额外保留对照表。这样后续叠加和维护更清楚。
总结
ArcGIS Pro 的重分类难点不在按钮,而在你是否把阈值依据、输入质量和结果用途分开管理。
只要先讲清为什么这样分,再去设置区间和复核结果,重分类就会从“做图步骤”升级成真正可信的分析环节。