ArcGIS Pro ModelBuilder 迭代器怎么用:批处理输入、命名规则与中间结果控制
问题场景:ModelBuilder 迭代器能批处理,但结果常常乱在命名上
很多人第一次在 ArcGIS Pro ModelBuilder 里用迭代器,感受到的最大好处是省去重复点击。真正做多批次任务时,最先失控的通常不是流程,而是 输入组织、中间结果和输出命名。
如果一个模型能跑,但输出文件名难以追踪、临时结果不断覆盖,那它还算不上真正可用的批处理流程。
先决定你在迭代什么
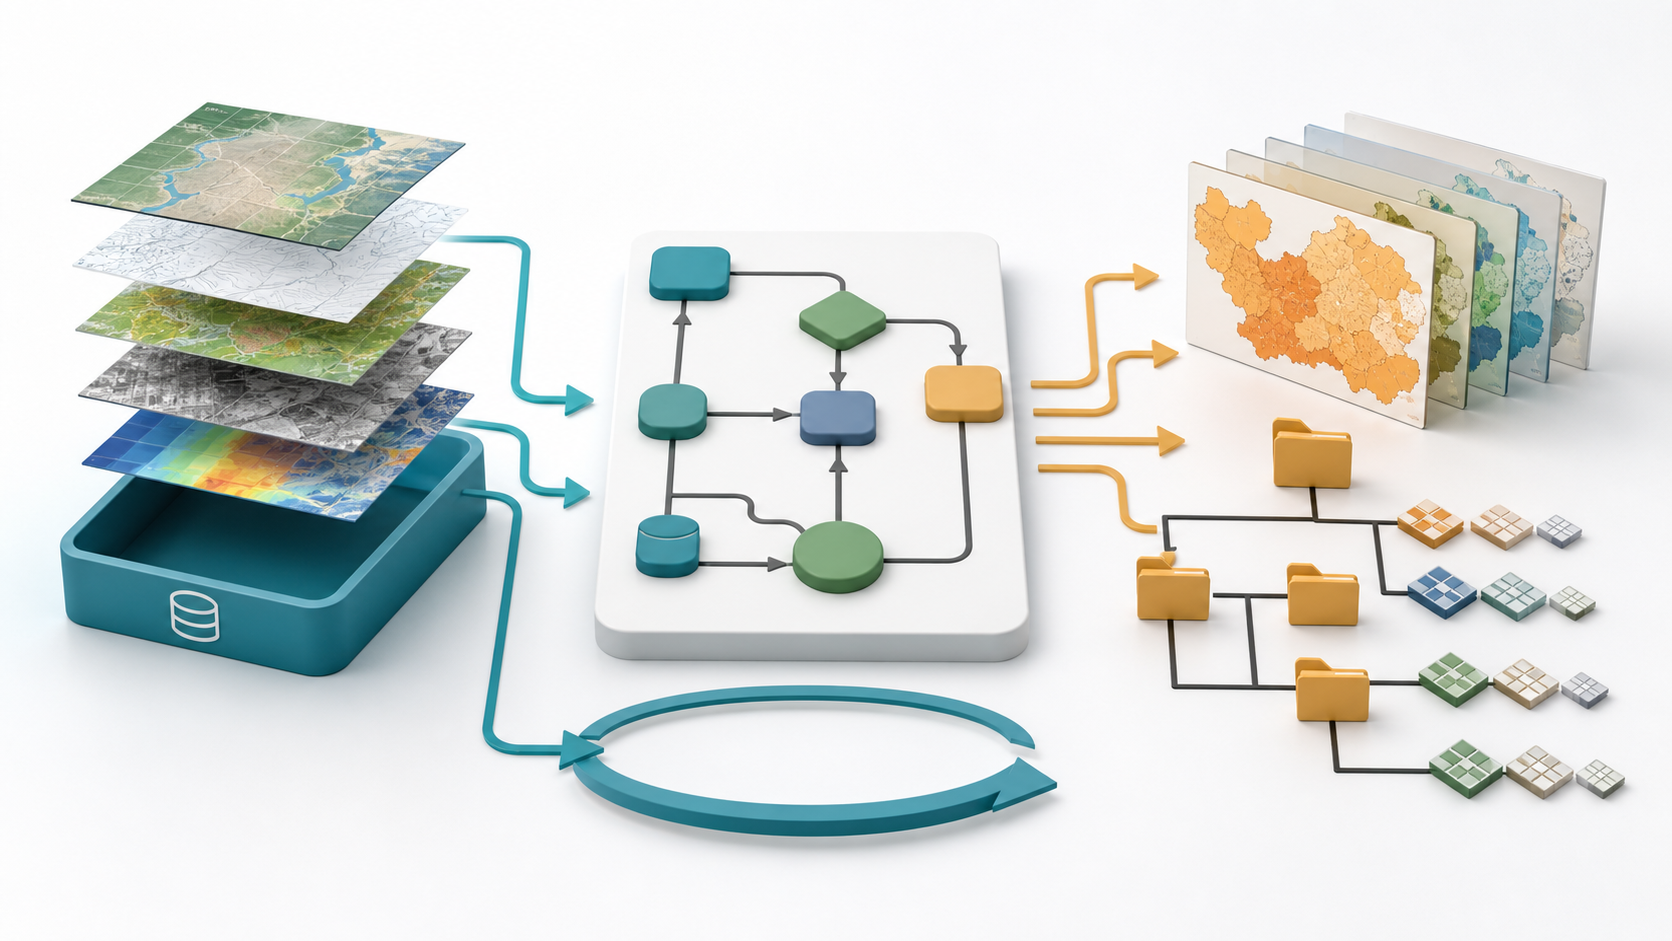
迭代器常见对象包括文件、要素类、字段值和行记录。不同迭代目标,对模型结构影响很大。比如按文件夹批量跑和按属性分类批量跑,命名策略就完全不同。
所以建模前先问一句:这次批处理的最小单位是什么?只有这个单位明确,后面的输出设计才不会漂。
命名规则比工具连接更重要
很多模型看起来复杂,其实工具本身没什么问题,麻烦都出在结果命名。建议至少把 数据来源、关键参数、批次标识 放进输出名里,这样回看成果时才能知道它是怎么来的。
| 命名元素 | 作用 | 建议 |
|---|---|---|
| 来源标识 | 区分输入对象 | 使用稳定短名 |
| 参数标识 | 区分不同处理方案 | 只保留关键参数 |
| 批次时间 | 区分不同运行轮次 | 用于正式输出而非全部中间件 |
实操流程:让模型既能跑又能复查
- 先在样本数据上跑通单次流程,再引入迭代器。
- 明确输出目录结构,区分正式成果与中间结果。
- 为关键输出设置可读命名规则,避免默认名字覆盖。
- 必要时关闭不需要保留的中间结果,减少磁盘压力。
- 跑完后抽查几组输入与输出对应关系,确认命名和结果一致。
我的习惯是先把模型做成‘少而清楚’,确认逻辑稳定后再往里加异常处理和更多分支。
项目避坑:不要让中间结果长期落在默认 geodatabase
默认 geodatabase 用起来方便,但项目一复杂,里面很快会积累大量同名或近似命名结果,后续排查极其费劲。
对临时结果和正式成果做目录隔离,是 ModelBuilder 从演示工具走向项目工具的第一步。
结果复核时要看什么
围绕“ArcGIS Pro ModelBuilder 迭代器怎么用:批处理输入、命名规则与中间结果控制”这类任务,真正有经验的做法不是工具跑完就结束,而是把结果放回业务场景里再看一遍。很多错误在参数面板里看不出来,一叠加到底图、一做样本抽查、一和已有成果对比,就会立刻暴露。
我更建议把复核分成三层:先看数量是否异常,再看空间位置或属性关系是否合理,最后看结果是否能被后续分析和制图稳定复用。只要这三层里有一层答不上来,就不要急着把结果当成正式成果。
- 抽查 5 到 10 个边界样本,确认最容易出错的位置是否合理。
- 对比处理前后记录数、值域或范围,判断是否出现意外膨胀、丢失或截断。
- 把关键参数、阈值和数据来源留档,确保后续可以复算。
把模型当作项目流程,而不是“自动点击器”
ModelBuilder 最有价值的时刻,往往不是你第一次把 30 个图层跑完,而是三周后换来一批字段名略有不同的数据,仍然能迅速定位流程在哪一步失效。为此,模型的输入、输出和临时路径都要有边界。
我会把真正要交付的成果放进固定目录,把可删的中间数据放进单独的 scratch 目录;每个关键节点都留一个能读懂的名称。这样即使某轮迭代中断,也不用从一堆默认名称里猜谁是谁。
能被另一位同事接手并复跑的模型,才算完成了自动化。
FAQ
迭代器跑完只剩最后一个结果怎么办?
通常是输出命名没有包含迭代变量,导致每轮都覆盖前一轮。
中间结果该不该保留?
关键节点建议保留以便排错,纯过渡结果可在确认稳定后关闭保留。
ModelBuilder 适合替代 ArcPy 吗?
适合流程稳定、交付给非程序同事复用的场景;复杂逻辑或大量条件分支时,ArcPy 往往更灵活。
总结
ModelBuilder 迭代器真正的价值,不只是减少点击,而是把重复任务做成可复查、可复跑的流程。
只要把迭代对象、命名规则和中间结果管理好,模型的稳定性会明显提升。