Python 用 rasterio 读大栅格:窗口读取、分块处理与内存控制
问题场景:大栅格不是读不进来,而是不能这么读
处理小影像时,`src.read()` 往往简单直接;一旦换成几个 G、几十 G 的栅格,问题就立刻变了。rasterio 不是不会读大数据,而是大数据不允许你继续沿用“小文件思维”。
很多人看到内存爆掉、Notebook 卡死,第一反应是机器不够强。实际更常见的原因,是代码一上来就把整幅栅格和所有波段全搬进内存,后面再做窗口裁剪、掩膜或统计。这种顺序在大数据上天生吃亏。
真正稳的做法,是承认你绝大多数时候并不需要一次持有全部像元。
为什么整图读取在大栅格上经常不是答案
| 读取方式 | 优点 | 代价 |
|---|---|---|
| 整图 read | 代码最短,调试直观 | 内存压力最大 |
| 窗口读取 | 按需取局部区域 | 需要规划窗口逻辑 |
| 按块遍历 | 更贴近文件内部结构 | 流程设计要更清楚 |
| 增量写出 | 结果稳,不堆内存 | 需要先想好输出组织 |
如果数据是多波段、高分辨率或者跨区域大影像,一次性 read 往往不是‘方便’,而是在给后续处理埋雷。尤其是数组在计算过程中被悄悄提升成更大 dtype 时,内存占用会比你预期高得多。
窗口读取和分块处理各自适合什么
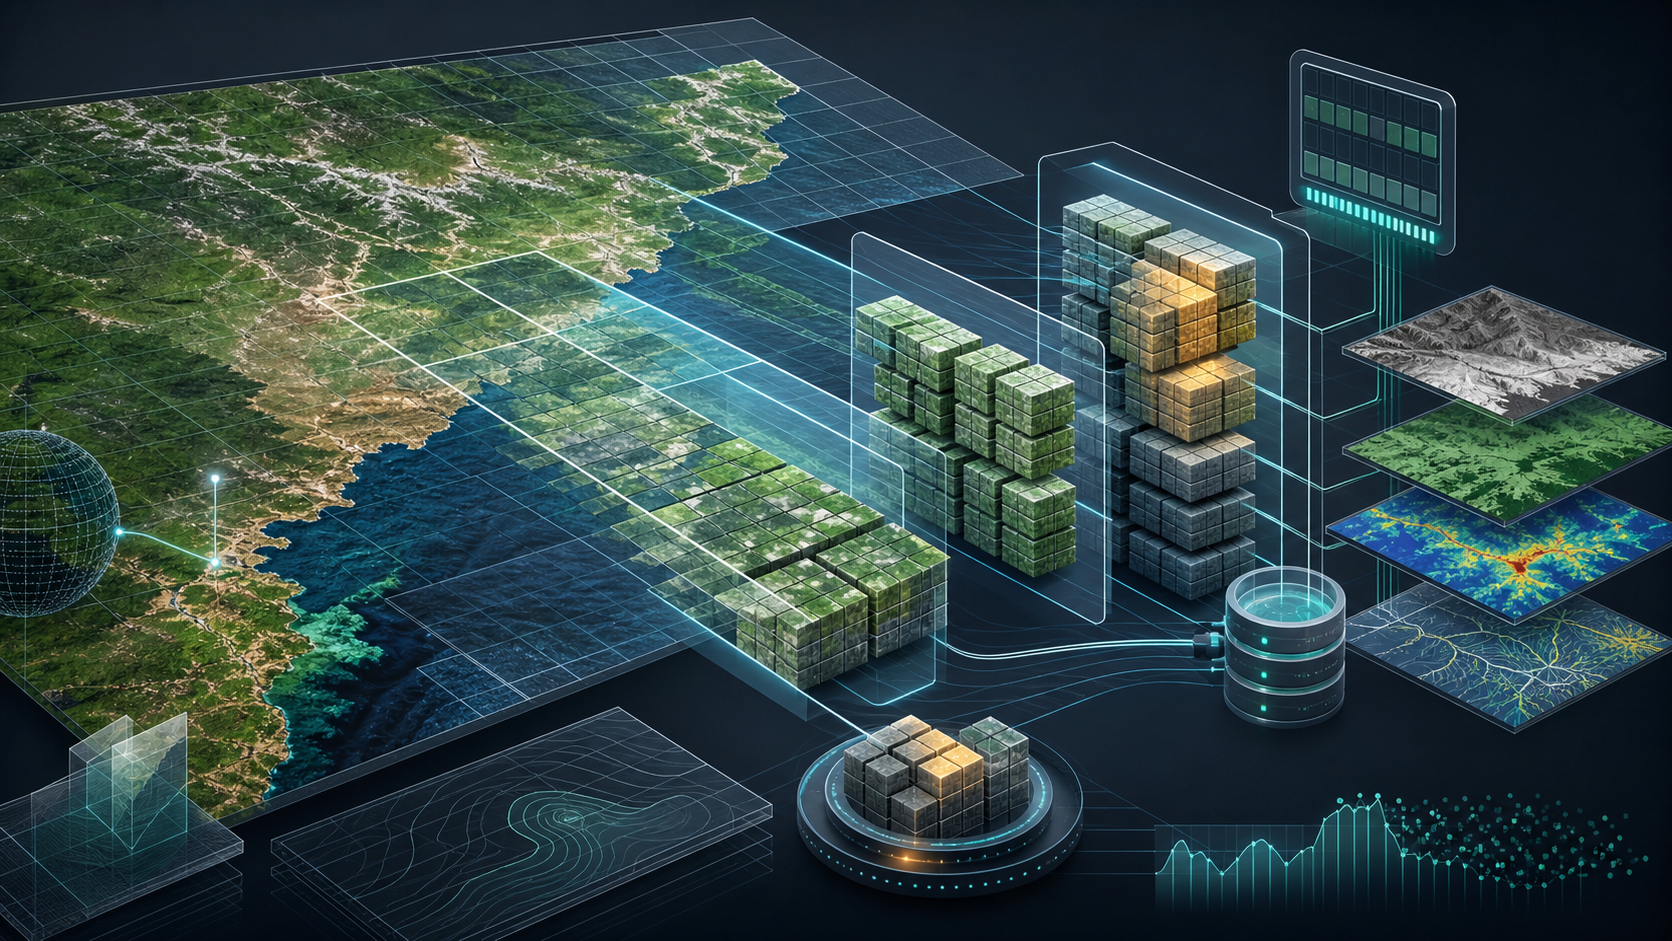
如果你有明确感兴趣区域,比如行政区裁剪、样方统计、滑窗分析中的局部计算,窗口读取很合适;如果你要扫整幅图做重分类、掩膜、分段统计或逐块导出,按块遍历通常更稳。
很多时候,最佳策略并不是二选一,而是先用窗口把范围缩小,再在窗口内部按块处理。关键是别在还没决定算什么之前,就先把整幅数据都读进来。
一个更像工程处理的流程
- 先查影像尺寸、波段数、dtype 和压缩情况,预估内存上限。
- 只读取确实需要的波段和范围,不默认全量读。
- 对整幅任务优先采用块遍历,对局部任务优先采用窗口读取。
- 边读边算、边算边写,避免把巨大的中间结果长期放在内存里。
- 记录块大小、处理耗时和 dtype 变化,为后续复跑留下依据。
真正做过几次大栅格处理以后,你会发现性能问题很少是某个库函数‘慢’,更多是 I/O 策略和内存策略一开始就没有设计好。
dtype 是一个特别容易被忽略的隐形炸点
原始数据可能只是 `uint16`,但你中间做了几步计算后,数组被提升成 `float64`,占用瞬间翻倍甚至更多。很多人排查半天都在看循环和算法,最后才发现真正吞内存的是数据类型。
所以每一步都要知道自己手里拿的是什么,不要默认让数组往最高精度长。够用就好,稳定比豪华更重要。
结果复核不只看程序有没有跑完
- 看内存曲线是否平稳,而不是一路上涨到接近极限。
- 看分块边界是否产生拼接缝或统计重复。
- 看输出结果与小范围样本整图计算是否一致。
FAQ
为什么 rasterio 处理大栅格时进程会被系统直接杀掉?
通常是一次性读取过多数据,导致内存耗尽。优先改成窗口读取或按块遍历。
分块处理会不会降低精度?
正常不会,前提是块边界处理一致,且算法不依赖被你截断掉的全局上下文。
什么时候整图读取仍然值得做?
只有在数据规模可控、算法确实依赖全局矩阵,而且你明确知道内存能扛住时。
总结
Python 用 rasterio 读大栅格,核心不是让机器硬扛,而是让数据以更合理的方式流过内存。
当你开始主动设计窗口、块结构和 dtype,很多原本看起来‘跑不动’的大栅格任务,其实都会变得稳定可控。