PostGIS ST_Subdivide 怎么优化大面叠加:顶点阈值、索引与边界复核
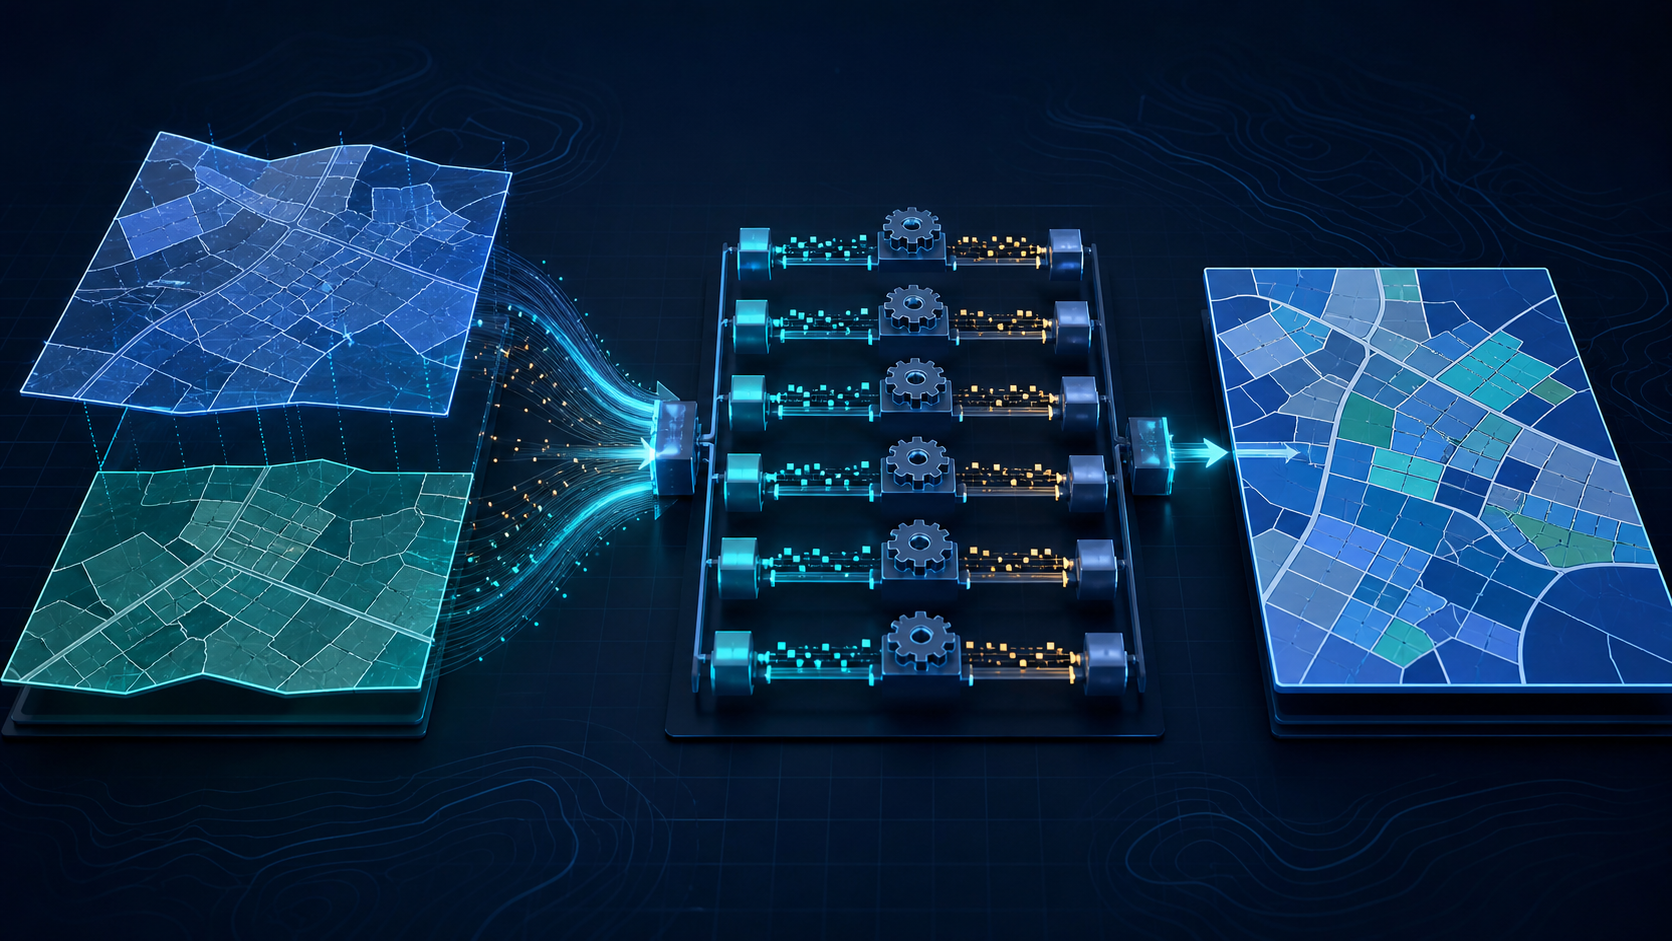
一条海岸线或行政边界带着几十万顶点,与道路、网格做空间叠加时,即使有 GiST 索引也会很慢。原因往往不是索引缺失,而是一个巨型外包矩形让太多候选要素进入精确计算。ST_Subdivide 可以把大几何切成更易过滤的块,但切分后的统计口径和边界去重必须提前想清。
PostGIS ST_Subdivide:先确定可验证的结果边界
细分的目的不是改变地物,而是改善候选过滤和计算颗粒度;任何切块都应能回溯到原对象。开始操作前,把输入批次、坐标参考、关键字段和成果用途写进处理记录;操作后至少比较数量、范围和一项业务统计。这样遇到异常时,才能定位是数据、参数还是规则出了问题。
索引先过滤包络框,再计算真实关系
巨大而狭长的几何包络框覆盖范围广,索引会返回大量假候选。切成小块可提高 bbox 选择率,让 ST_Intersects 或 ST_Intersection 少做无效精算。
max_vertices 是性能与碎片的平衡
阈值越小,单块越简单,但行数、索引和后续汇总成本越高。应以典型查询的耗时和候选数选择,而不是盲目设成很小。
切分表是计算加速层,不是权威边界
业务主表仍保存完整原始几何;切分表保存 source_id、part_no 和 geom。面积、行政属性等对象级字段不要在切分表直接重复求和。
可执行实操流程
- 用 EXPLAIN ANALYZE 记录原查询的候选数、耗时和是否使用 GiST 索引;先确认 SRID 一致。
- 建立包含 source_id 的细分表,分别试验 128、256、512 等顶点阈值,并分析块数与 bbox 分布。
- 对细分 geom 建 GiST 索引并 ANALYZE;查询时先基于切分块筛选,再回连原对象或按 source_id 聚合。
- 比较原几何与细分块 union 后的面积、范围和有效性;重点抽查狭长边界与孔洞附近。
- 记录阈值、PostGIS 版本、索引定义与压测 bbox,作为后续数据更新的性能基线。
CREATE TABLE coast_parts AS
SELECT id AS source_id, (ST_Dump(ST_Subdivide(geom, 256))).geom AS geom
FROM coastline;
CREATE INDEX coast_parts_gix ON coast_parts USING gist (geom);
项目避坑与质量检查
不能对切分表中的对象级人口、面积字段简单 SUM。每块都复制了原值,会得到成倍放大的统计。切分表只用于空间候选过滤;需要统计时回连原表,或只使用根据切块实际面积计算的部件级指标。
| 检查节点 | 应保留的证据 | 异常时的第一动作 |
|---|---|---|
| 输入 | 来源、范围、CRS、字段统计 | 回看原始批次与空值/重复值 |
| 处理中 | 参数、日志与抽样结果 | 在最小样本复现而非直接重跑全量 |
| 输出 | 数量、范围与关键业务统计 | 与基线或人工判读样本比对 |
让流程可以被同事复跑
把这次选择的参数、拒绝的候选方案和抽样位置一并保存。GIS 项目最难交接的不是工具名称,而是某个阈值为何合理、某个异常为何可以接受。将这些判断写在处理日志中,数据更新后才能用同一把尺子复核。
复核记录应至少能回答三件事:输入数据从哪里来、为什么选这个参数、异常结果如何处置。把这三项与一份小样本结果绑定保存,比只留最终截图更能抵御人员交接、数据更新和审核追问。
FAQ
ST_Subdivide 会改变原始边界吗?
它生成新的切分几何,不会修改原表;应始终保留原几何作为权威来源。
阈值应该设多少?
从代表性查询开始比较候选数、块数和耗时,没有适用于所有数据的固定值。
切分后为什么还要做边界复核?
复杂孔洞、无效几何和极细边界可能在后续叠加中暴露问题,面积与空间抽检能及时发现。
总结
ST_Subdivide 的价值在于让空间索引更会“挑选候选”,而不是把复杂边界永久切碎。可靠的 GIS 成果不只是一张看起来正确的图,而是输入边界、参数理由和复核证据都经得起追问的可复现过程。