PostGIS 最近点查询怎么写:ST_DWithin、KNN 索引与距离排序
问题场景:最近点查询最怕的是结果对,但系统扛不住
很多 PostGIS 最近点查询 示例都能跑出正确结果,可一旦数据量上来,查询时间就会迅速暴露问题。最典型的情况是:SQL 逻辑上没错,但它让数据库先算了太多不必要的距离。
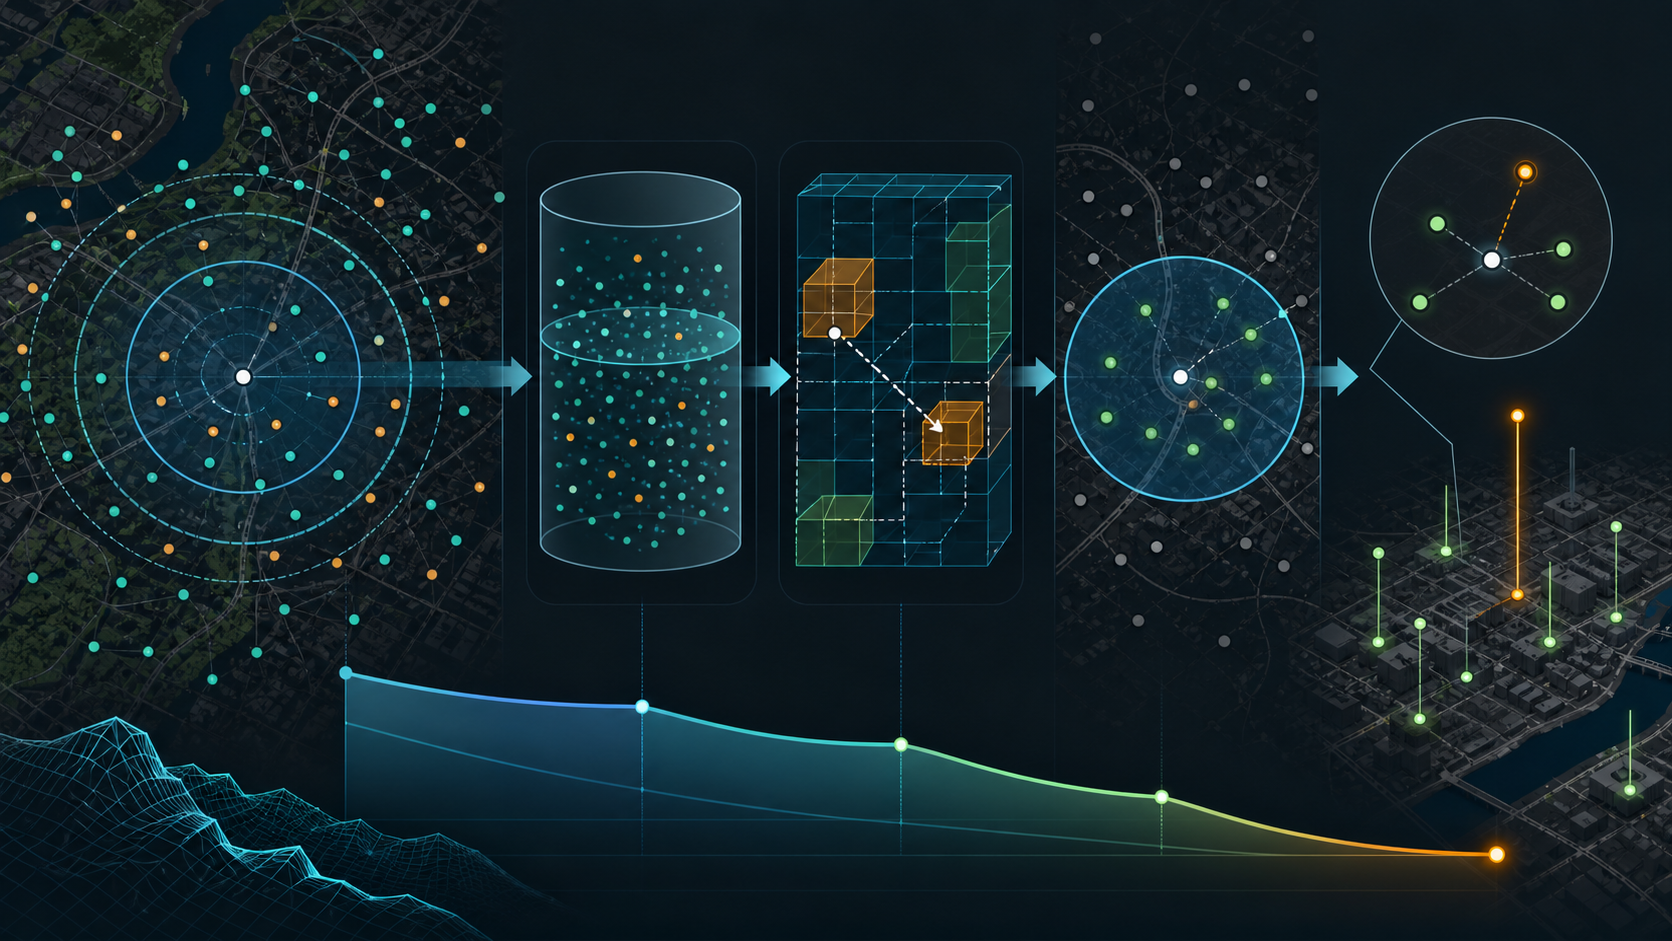
最近点查询如果只关注“怎么算最近”,而不关注“怎么先缩小候选集”,那它在生产环境里通常很难优雅。空间数据库的优势从来不只是会算距离,而是会借助索引和过滤把问题先变小。
ST_DWithin、KNN 和 ST_Distance 分别做什么
| 方法 | 主要职责 | 实践建议 |
|---|---|---|
| ST_DWithin | 先按距离阈值过滤候选 | 优先放在前面收窄范围 |
| KNN 排序 | 快速找最近候选 | 依赖空间索引发挥价值 |
| ST_Distance | 返回精确距离 | 放在缩小候选集之后更稳 |
| EXPLAIN ANALYZE | 检查执行计划 | 别凭感觉判断是否优化成功 |
很多人一上来就 `ORDER BY ST_Distance(…)`,这不是不对,而是太贵。数据库需要为大量对象计算精确距离,数据一大,性能很快就吃不消。
坐标系决定距离有没有业务意义
这一点经常被忽略。你如果在经纬度上直接做距离排序,再把结果解释成米,技术上或许能返回一组最近对象,但业务上不一定可靠。
所以最近点查询的第一层,不是 SQL,而是 距离单位是否可信。要么投影到合适的平面坐标系,要么明确使用 geography 并接受它的计算成本。
一个更稳的最近点查询思路
- 先给几何列建立空间索引,并确认执行计划里真的走了索引。
- 确认坐标系和距离单位,别在错误单位上讨论性能。
- 优先用 ST_DWithin 过滤候选,再用 KNN 排序找最近对象。
- 只返回必要字段,把大对象或大文本留在后续详情查询里。
- 用 EXPLAIN ANALYZE 看真实耗时,而不是凭主观感觉判断优化是否成功。
如果是批量匹配任务,还可以先按网格、行政区或业务分区做预分桶,再在局部范围内做最近点计算,这通常比全局暴力查询更稳。
项目现场里最常见的误区
最常见的误区其实不是不会建索引,而是把‘精确距离计算’放在流程最前面。数据库在大规模数据上最擅长的是先排除不可能,再精算最可能。顺序一反,性能差异会很明显。
这个思路和桌面 GIS 的空间筛选一样:先缩范围,再细判断。数据库里也遵循同一逻辑。
结果复核不能只看返回结果对不对
- 看执行计划是否真的使用了空间索引。
- 看距离单位是否与你业务解释一致。
- 看查询在样例数据和真实数据量下的耗时差别。
FAQ
为什么最近点查询没有走索引?
先检查几何列是否建立了正确的空间索引,再看 SQL 写法是否给优化器留下使用索引的机会。
经纬度数据能直接做最近点排序吗?
能做,但距离解释要谨慎。更稳的做法是投影到合适坐标系,或明确使用 geography。
ST_DWithin 的阈值应该怎么设?
按业务允许的最大候选搜索半径来设,而不是为了图快随意拍一个数字。
总结
PostGIS 最近点查询要又对又快,核心是让数据库先少算,再精算。
当你把坐标系、候选过滤、索引排序和执行计划一起管住,这类查询通常就能从示例代码走进真实生产环境。