
GeoPandas 怎么读取 Shapefile、GeoJSON 等数据

GeoPandas 读取 Shapefile、GeoJSON、GeoPackage 等矢量数据,直接调用 geopandas.read_file() 即可,返回 GeoDataFrame。自 1.0.0 起默认 I/O 引擎为 Pyogrio(更快),也可切回 Fiona;扩展名会自动识别格式,也可显式指定 driver 或 layer。截至 2026 年 11 月,稳定版为 1.2.0,按路径、URL 或 ZIP 都能读。
安装环境与依赖确认
先解决“装不上或导入报错”的问题。GeoPandas 1.2 要求 Python ≥3.11,以及 pandas ≥2.2、numpy ≥2.0、shapely ≥2.1、pyproj ≥3.7、pyogrio ≥0.8 等。强烈建议用 conda-forge,避免 GDAL/GEOS/PROJ 编译失败。
- 创建并激活干净环境:conda create -n geo_env,再 conda activate geo_env。
- 添加通道并安装:conda install –channel conda-forge geopandas(或先设严格优先级再装)。
- 可选加速:再装 pyarrow、matplotlib 等;需要 Fiona 时单独装。
- 验证:在 Python 里 import geopandas as gpd,再 import pyogrio; print(pyogrio.list_drivers()) 看支持的驱动。
pip 也能装(pip install geopandas),但部分平台可能缺 C 库,优先 conda。更多安装细节与实战源码可看本站 GeoPandas怎么读?GIS空间分析实战(附:源码)。
用 read_file 读取 Shapefile、GeoJSON 的步骤
核心就一行:指定文件(或 URL/ZIP),得到带 geometry 列的 GeoDataFrame。Shapefile 只要给 .shp 路径(同目录需有 .shx、.dbf,建议有 .prj);GeoJSON 是单文件。
- 准备数据:把 .shp 套件放同一文件夹,或准备 .geojson / .json;ZIP 可用 zip:///path/to/file.zip 或带内部路径的写法。
- 基本读取:gdf = gpd.read_file(“data/xxx.shp”) 或 gdf = gpd.read_file(“data/xxx.geojson”)。
- 多图层文件(如 GeoPackage):加 layer=”图层名”。
- 远程或内存:直接传 URL,或传已打开的文件对象、pathlib.Path。
- 验收:打印 gdf.head()、gdf.crs、len(gdf),必要时 gdf.plot() 看几何是否正常。
官方示例写法类似 geopandas.read_file(“nybb.shp”)。完整案例与附源码见 GeoPandas怎么读?GIS空间分析实战(附:源码)。
常用参数怎么选(过滤、编码、引擎)
大文件或只要局部数据时,用参数先裁再读,能明显提速。默认引擎是 pyogrio;行为不一致时可改 engine。
| 参数 | 作用 | 注意点 |
|---|---|---|
| bbox | 按边界框过滤 | tuple 或几何;pyogrio 要求 CRS 一致 |
| mask | 与给定几何相交过滤 | 适合不规则范围 |
| rows | 限制行数或切片 | 整数或 slice,先摸底数据用 |
| columns | 只读指定字段 | 减少内存 |
| encoding | 指定字符编码 | 中文 Shapefile 常用 gbk / gb18030 |
| engine | “pyogrio”(默认)或 “fiona” | 兼容问题时切 fiona |
| use_arrow | True 时用 Arrow 加速 | 需安装 pyarrow,常能快 2–4 倍 |
| layer / driver | 指定图层或驱动 | 多图层或自动识别不准时用 |
- 中文属性乱码:读取时加 encoding=”gbk”(或 gb18030、utf-8),写入时指定 encoding 会生成 .cpg。
- 无投影或 CRS 错:读完后 gdf.set_crs(“EPSG:xxxx”, allow_override=True),再做空间运算。
- 复杂/超大 GeoJSON:可用 pyogrio 配置放宽对象大小限制,或配合 rows/bbox/mask。
读取失败时怎么排查与验收
报错多半出在配套文件缺失、编码、CRS 不一致或引擎差异。按下面顺序查:
- Shapefile 缺 .shx/.dbf → 补齐同名文件;ZIP 路径写错 → 用官方 zip:// 格式并确认内部相对路径。
- 编码乱码 → 试 encoding,或用 QGIS/ogr2ogr 另存为 UTF-8 再读。
- 引擎行为不同(EMPTY 几何、嵌套属性等)→ 加 engine=”fiona”,或全局 geopandas.options.io_engine = “fiona”。
- 缺少驱动 → 查 pyogrio.list_drivers();依赖不全就回 conda 重装。
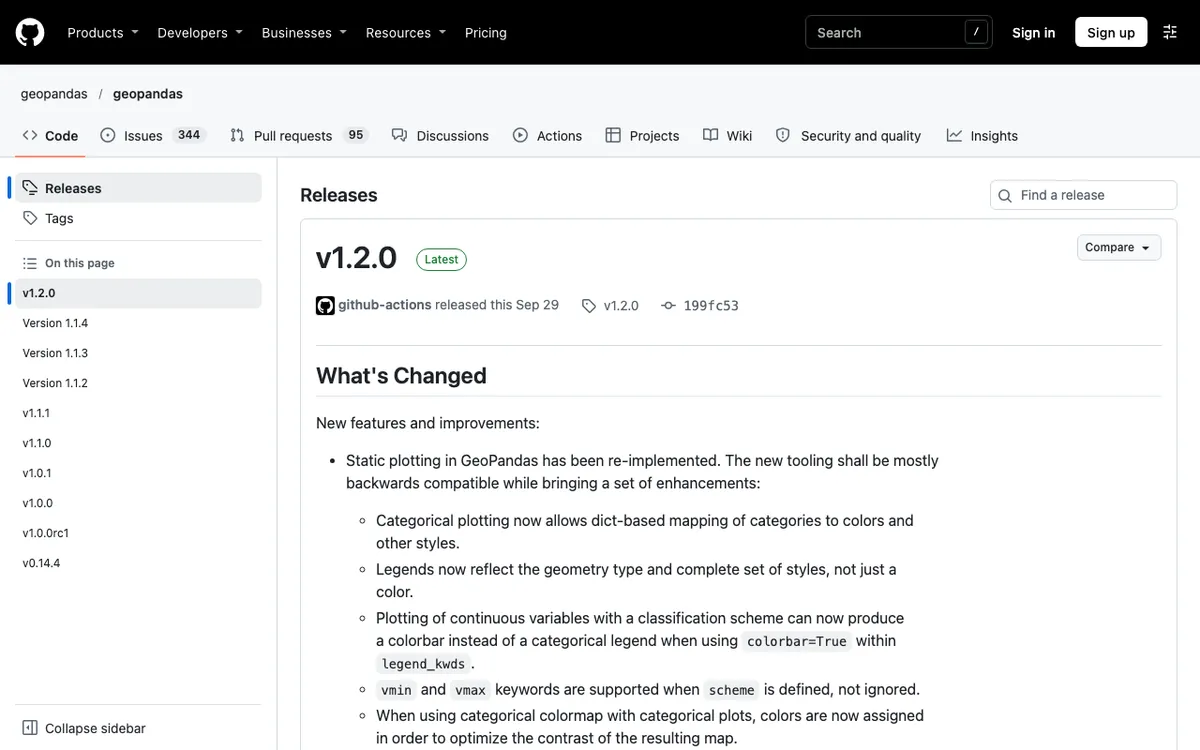
验收标准:能正常 import;gdf.geometry 非空且类型正确;gdf.crs 符合预期;空间过滤后结果行数合理;简单 plot 无异常。版本与依赖可到 GeoPandas GitHub Releases 核对。
常见问题
为什么读中文 Shapefile 全是乱码?
DBF 常不是 UTF-8。读取时加 encoding=”gbk” 或 “gb18030″;若仍乱,用 QGIS 另存并指定编码,或检查/新建同名 .cpg 文件。
默认 Pyogrio 和 Fiona 有什么区别?要不要切回去?
Pyogrio 批量读写通常快很多,是 1.0 后默认。若遇到 EMPTY 几何、schema 或某些 GeoJSON 属性表现不一致,临时用 engine=”fiona” 即可。
能直接读网上的 GeoJSON 或 ZIP 里的 shp 吗?
可以。read_file 支持 URL;ZIP 用 zip:///路径 或 zip:///路径!内部文件.shp。注意网络与路径拼写正确。
读完后怎么确认 CRS 和几何没问题?
看 gdf.crs;无投影就 set_crs。再检查 gdf.is_valid、缺失几何,必要时用简单 plot 或空间相交做抽检。
总结:日常用 gpd.read_file 读 Shapefile/GeoJSON,优先 conda 装齐依赖,中文加 encoding,大文件用 bbox/mask/rows,引擎不合适就切 Fiona。建议先在小样数据上验收 CRS 与行数,再上正式流程;完整步骤与源码可直接参考 GeoPandas怎么读?GIS空间分析实战(附:源码)。