遥感分类精度怎么评估:混淆矩阵、验证样本与面积校正
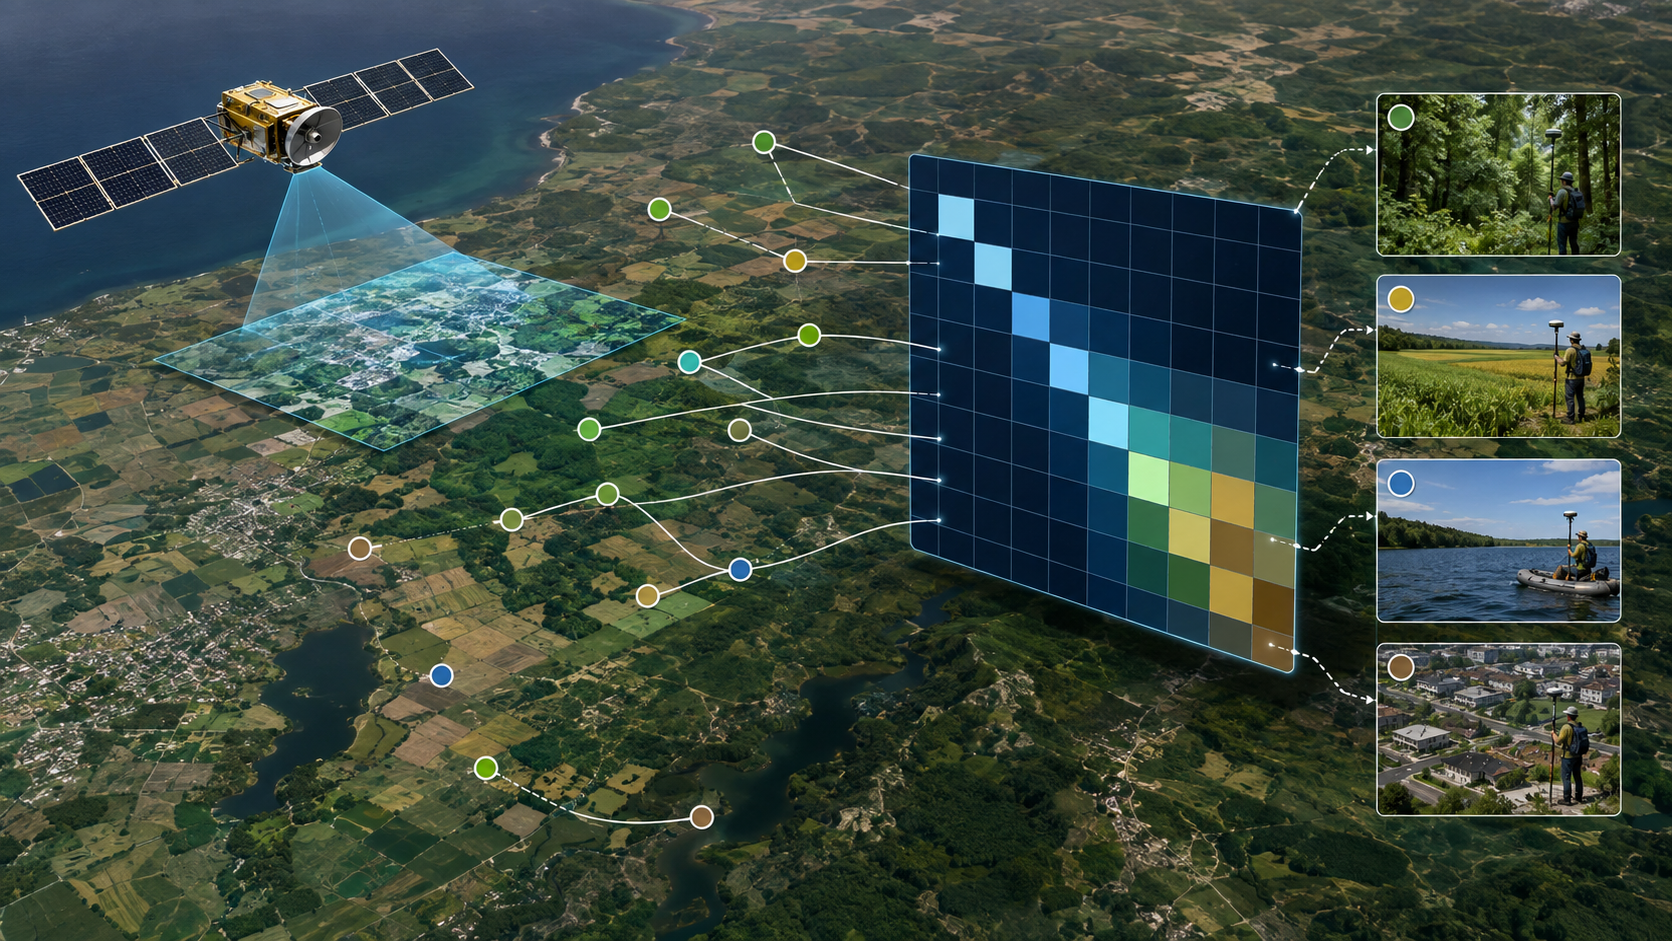
一张土地覆盖分类图颜色鲜明,并不代表精度可靠。若训练样本与验证样本来自同一批点、类别不平衡,或抽样只覆盖易到达区域,整体精度可能很好看,却无法支持面积统计和管理决策。遥感分类精度评估的核心是让验证样本真正独立且代表目标区域。
遥感分类精度评估:先确定可验证的结果边界
精度指标不是模型的装饰,而是分类图能否用于面积、变化或监管判断的证据链。开始操作前,把输入批次、坐标参考、关键字段和成果用途写进处理记录;操作后至少比较数量、范围和一项业务统计。这样遇到异常时,才能定位是数据、参数还是规则出了问题。
混淆矩阵揭示错在何处
总体精度把所有类别压成一个数,容易掩盖小类或关键类别的漏分。生产者精度关注真实地物被识别的比例,用户精度关注地图标成某类后有多少是真的;两者应与业务风险一起看。
验证样本必须独立且空间上有代表性
从训练区附近随机抽点会高估精度,因为空间自相关让相邻像元过于相似。应按类别和区域分层抽样,并保持训练、验证样本互不重叠。
面积统计需要考虑抽样设计
各类样本数均衡时便于比较模型,却不代表地表比例。若用分类像元直接汇总面积,可能带入分类偏差;需要依据验证样本和抽样权重进行面积与不确定性校正。
可执行实操流程
- 明确分类图用途、目标类别、最小制图单元和时间范围,冻结待评估成果版本。
- 建立独立验证样本,按类别与空间分层;记录影像日期、判读依据和不确定标签。
- 提取分类值与参考值,生成混淆矩阵,并输出总体、用户、生产者精度及每类样本数。
- 重点复核对业务影响最大的混淆对,例如建设用地与裸地、水体与阴影,而不是只追求总体值。
- 若用于面积报告,保留抽样权重并计算校正面积与置信区间;将样本、脚本和矩阵一起归档。
参考类别  分类类别 | 林地 | 建设用地 | 水体
林地                    |  82 |  9 |  3
建设用地                |   7 | 76 |  2
水体                    |   2 |  3 | 61
项目避坑与质量检查
验证点不是越多越好而已。一次项目在农田区采到大量高质量样本,却几乎没有阴影、裸地和边缘建设用地,整体精度被乐观样本拉高。抽样设计应先保障关键类别和易混区域的代表性,再增加样本量。
| 检查节点 | 应保留的证据 | 异常时的第一动作 |
|---|---|---|
| 输入 | 来源、范围、CRS、字段统计 | 回看原始批次与空值/重复值 |
| 处理中 | 参数、日志与抽样结果 | 在最小样本复现而非直接重跑全量 |
| 输出 | 数量、范围与关键业务统计 | 与基线或人工判读样本比对 |
让流程可以被同事复跑
把这次选择的参数、拒绝的候选方案和抽样位置一并保存。GIS 项目最难交接的不是工具名称,而是某个阈值为何合理、某个异常为何可以接受。将这些判断写在处理日志中,数据更新后才能用同一把尺子复核。
复核记录应至少能回答三件事:输入数据从哪里来、为什么选这个参数、异常结果如何处置。把这三项与一份小样本结果绑定保存,比只留最终截图更能抵御人员交接、数据更新和审核追问。
建议在正式处理前固定一组“正常、边界、异常”样本。每次更新数据或工具后都重跑这组样本;若数量、范围或关键指标变化,先解释变化来源,再决定是否进入全量生产。
FAQ
总体精度高为何仍不能发布?
关键类别可能仍有严重漏分或误分。应查看每类的用户、生产者精度和混淆关系。
验证样本能否复用训练样本?
不应直接复用。这样评估的是对已见样本的拟合,无法反映独立泛化能力。
面积为什么还要校正?
类别面积会受分类错误影响;结合验证样本与抽样权重能给出更可靠的面积及不确定性。
总结
遥感分类图的可信度不在配色,而在独立样本、完整混淆矩阵和与用途一致的面积不确定性说明。可靠的 GIS 成果不只是一张看起来正确的图,而是输入边界、参数理由和复核证据都经得起追问的可复现过程。