
ArcPy批量处理多个Shapefile

用 ArcPy 批量处理多个 Shapefile,核心做法是先把 arcpy.env.workspace 指到存放 .shp 的文件夹,再用 ListFeatureClasses() 或 ListFiles(“*.shp”) 列出要素类,然后用 for 循环逐个调用 Buffer、Clip、Project、CopyFeatures 等工具。需要递归子文件夹时用 arcpy.da.Walk;若目标统一(例如同一坐标系),可直接用官方 BatchProject 等批处理工具。输出命名建议基于输入名并去掉 .shp 后缀,同时打开 overwriteOutput,复杂流程优先写到文件地理数据库以减少锁冲突。
如何列出文件夹里的多个 Shapefile
批量处理的第一步是“把该处理的文件列出来”。Shapefile 在 ArcPy 里被当作要素类,只要工作空间设对,列表函数就能拿到它们。常见两种做法:文件夹内直接列出,或递归遍历含子目录的树。
- 把输入文件夹设为工作空间:arcpy.env.workspace = r”D:\data\input_shp”(路径用原始字符串,避免反斜杠转义)。
- 列出要素类:fc_list = arcpy.ListFeatureClasses()。若只想抓 .shp,也可用 arcpy.ListFiles(“*.shp”)。
- 需要扫子文件夹时,改用 arcpy.da.Walk(workspace, datatype=”FeatureClass”),它比普通 os.walk 更懂 ArcGIS 数据类型,能正确识别 Shapefile、要素数据集等。
- 拿到列表后用 for 循环处理;输出路径建议拼成“输出目录 + 输入基名 + 后缀”,基名可用 os.path.splitext 去掉 .shp。
工作空间必须是文件夹或地理数据库,不能写成单个 .shp 的路径,否则 ListFeatureClasses 会返回空。官方对列表函数与 Walk 的说明可参考 ArcGIS Pro 列出数据文档。更完整的脚本模板与命名示例,见本站 ArcPy批量处理怎么做与代码模板。
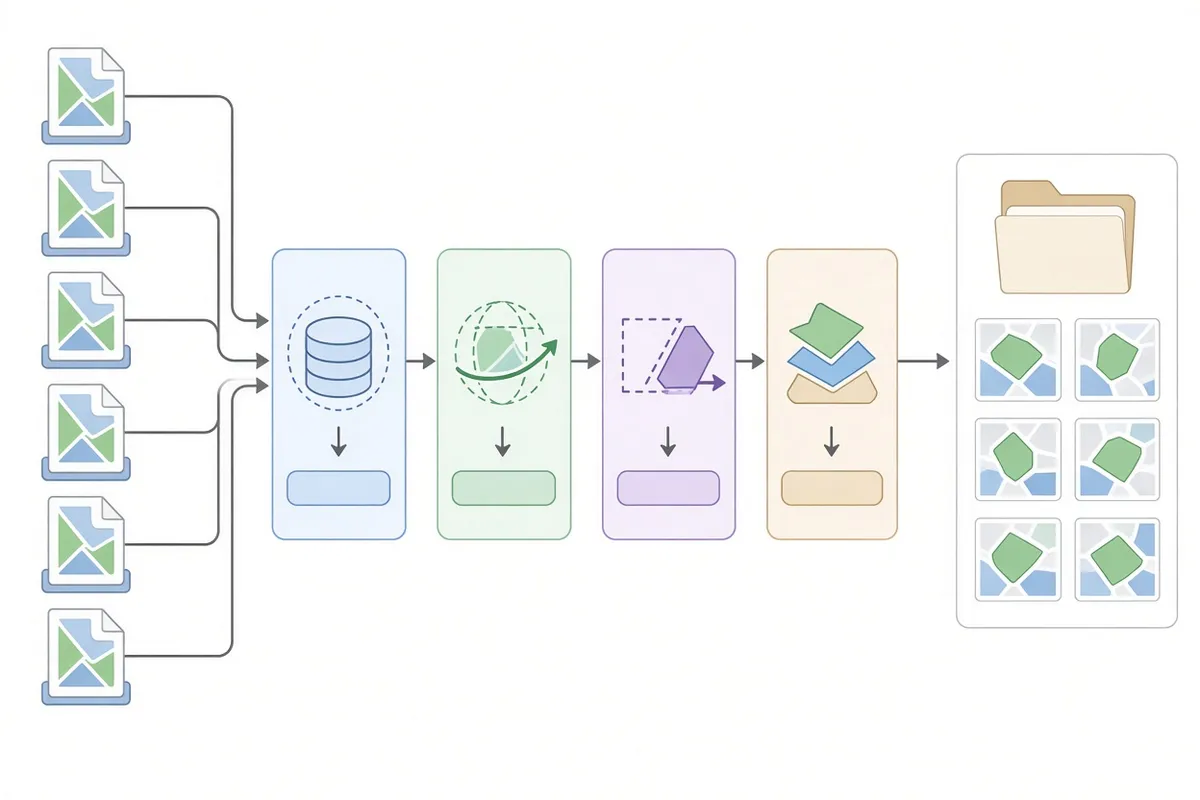
用 for 循环批量调用地理处理工具
列出文件之后,标准模式就是:设置环境 → 循环 → 调工具 → 按输入名写输出。几乎所有管理与分析工具都能这样包一层,例如 Buffer、Clip、Dissolve、Project、Merge、CopyFeatures。
- 先设 arcpy.env.overwriteOutput = True,避免第二次运行因同名文件报错。
- 循环体内用输入要素名构造输出名;若输出是 Shapefile,注意工具有时会自动追加 _1,可用 Exists + Delete_management 先清掉旧结果。
- 中间结果可写到 in_memory(或 memory),加快读写并减轻磁盘锁,最终再 CopyFeatures 到目标位置。
- 大量文件合并时,一次 Merge 容易触发 ERROR 999998,可改为先建空要素类再循环 Append,更稳。
若你手上有近百个同结构 Shapefile,需要裁剪、投影或统一入库,可直接对照本站实战写法:用ArcPy批量处理100个Shapefile文件。批量投影、批量裁剪的专项写法也整理在 ArcPy批处理、批量投影和批量裁剪 一文中,可按场景复制改造。
官方 BatchProject 与批量导入怎么用
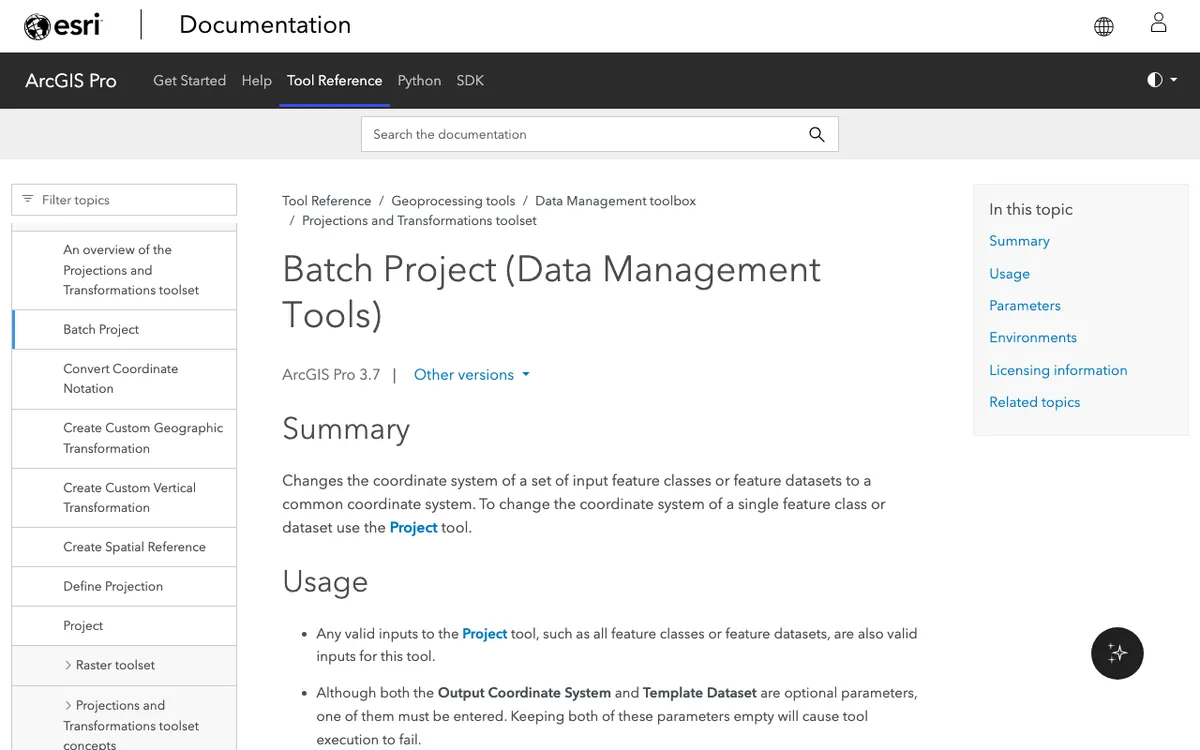
当所有输入要投到同一坐标系时,不必手写循环投影,可直接调用 arcpy.management.BatchProject。它接受一组要素类(含 Shapefile),输出到指定文件夹或地理数据库,并以输入名命名;重名时自动加数字后缀。需指定输出坐标系或模板数据集之一,并按需填写地理变换。
| 项目 | 说明 |
|---|---|
| 主要输入 | 多个要素类 / 要素数据集(含 .shp) |
| 输出位置 | 文件夹或地理数据库 |
| 坐标系 | 输出坐标系,或用模板数据集提供 |
| 地理变换 | 可选;跨基准面时建议明确填写 |
| 许可级别 | Basic / Standard / Advanced 均可 |
工具参数与 Python 示例见官方说明:Batch Project 工具参考。另外,若目标是把文件夹里一批 .shp(以及 KML、CSV、GeoJSON 等)导入同一地理数据库,可用 Intelligence 工具箱里的 BatchImportData,支持通配符(如 *.shp)和是否递归子文件夹。截至 2026 年 11 月,这些工具随 ArcGIS Pro(当前主流版本为 3.7)提供,具体界面以本机安装为准。
覆盖、文件锁与性能要注意什么
Shapefile 批处理最常见的坑是覆盖失败和锁文件。处理前把这些约定写进脚本习惯里,能少排很多错。
- 覆盖:仅设 overwriteOutput 有时不够(部分转换工具会改名另存)。先用 arcpy.Exists 判断,存在则 Delete_management,再写新结果。
- 锁:.lock 多半来自 ArcGIS Pro 仍打开该数据、另一个脚本未结束,或游标/图层对象未释放。脚本里对 row、cursor、图层变量及时 del,必要时 gc.collect();关掉占用该数据的工程后再跑。复杂批处理尽量改写到文件地理数据库,锁比 Shapefile 好控。
- 多进程:可用 Python multiprocessing 加速转换类任务,但文件地理数据库不要多进程同时写入同一库;每进程独立输出目录,或用企业级地理数据库。启动时注意把可执行文件指到 Pro 的 pythonw.exe。
- 坐标系:未定义投影的 Shapefile 先 DefineProjection,再参与投影/叠加,避免静默错位。
- 验收:跑完后抽查件数、字段、空间参考是否与预期一致;可用 GetCount_management 和 Describe 做简单断言。
大批量、长流程时,优先“列表 → 循环 → 写 GDB → 必要时再导出 Shapefile”,比全程死磕 .shp 更省心。
常见问题
ListFeatureClasses 为什么返回空列表?
多半是 workspace 指错了:应指向含 .shp 的文件夹或 GDB,而不是某个 .shp 文件本身。确认路径存在、扩展名正确,需要子目录时改用 arcpy.da.Walk。
第二次运行总是提示无法覆盖或生成了 _1 文件?
打开 overwriteOutput,并对目标路径先 Exists 再 Delete。同时关闭 Pro 里打开该数据的地图/表格,删掉残留 .lock 后再试。输出到 GDB 通常比直接覆盖 Shapefile 更干净。
循环里 Merge 很多大文件失败怎么办?
避免一次性 Merge 全部;改为创建空输出要素类,再在循环里 Append。中间层用 in_memory,最终落盘,可降低内存峰值和锁时间。
可以脱离 ArcGIS Pro 单独安装 ArcPy 做批处理吗?
ArcPy 随 ArcGIS Pro(或 Server)提供,需有效许可;可用 conda 从 Esri 通道安装匹配版本的 arcpy,但仍依赖已安装的 Pro。独立脚本请指向 Pro 自带的 Python 环境运行。
总结:批量处理多个 Shapefile,抓住“设 workspace → 列表(或 Walk)→ for 循环调工具 → 规范命名与覆盖”这条主线即可;统一投影优先用 BatchProject,入库可用批量导入类工具。建议日常输出默认落到文件地理数据库,并把 Exists/Delete 与锁释放写进模板;需要现成脚本骨架时,优先复用本站已有的批量投影/裁剪与百文件实战示例,再按自己的目录结构改路径与工具参数。